Các lỗi crawl và index thường gặp: Cách kiểm tra và khắc phục
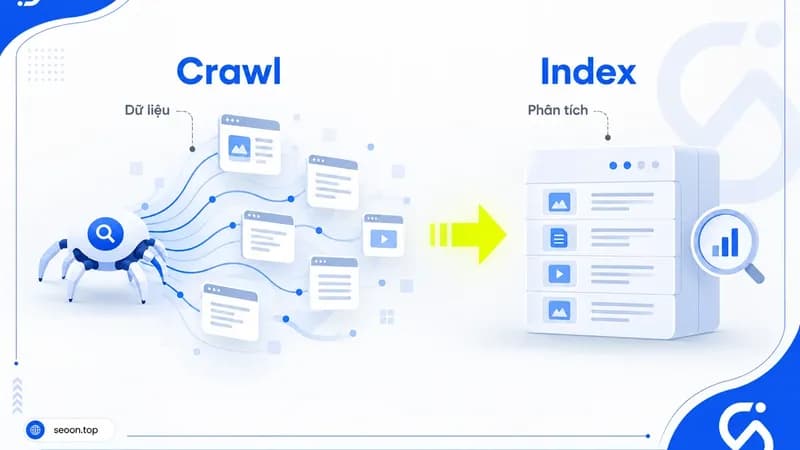
Phân biệt Crawl và Index
- Crawl là quá trình Googlebot truy cập và tải dữ liệu trang.
- Index là quá trình Google xử lý, đánh giá nội dung và đưa thông tin phù hợp vào chỉ mục tìm kiếm.
Trang tải thành công vẫn có thể không được lập chỉ mục; được index cũng không bảo đảm xếp hạng cao.
Crawlability (khả năng được thu thập) khác indexability (khả năng đáp ứng điều kiện lập chỉ mục). Đồng thời việc URL đáp ứng cả hai yếu tố này cũng không bảo đảm sẽ được Google index.
Bảng phân biệt lỗi crawl và lỗi index
Tiêu chí | Vấn đề crawl | Vấn đề/trạng thái index |
|---|---|---|
Giai đoạn | Truy cập, tải dữ liệu | Xử lý, lựa chọn nội dung |
Dấu hiệu | Bot không tải được trang | URL chưa có trong chỉ mục |
Ví dụ | Mã trạng thái HTTP 500 | Noindex, bản trùng lặp |
Công cụ | Crawl Stats, kiểm tra phản hồi | Pages, URL Inspection |
Hướng xử lý | Khôi phục truy cập | Rà chỉ thị, nội dung, URL chuẩn |
Bản đồ Crawl-to-Index
Phát hiện → Crawl (tải trang) → Render (dựng nội dung từ mã/tài nguyên) → Chọn URL chuẩn (xác định bản đại diện) → Index (lập chỉ mục).
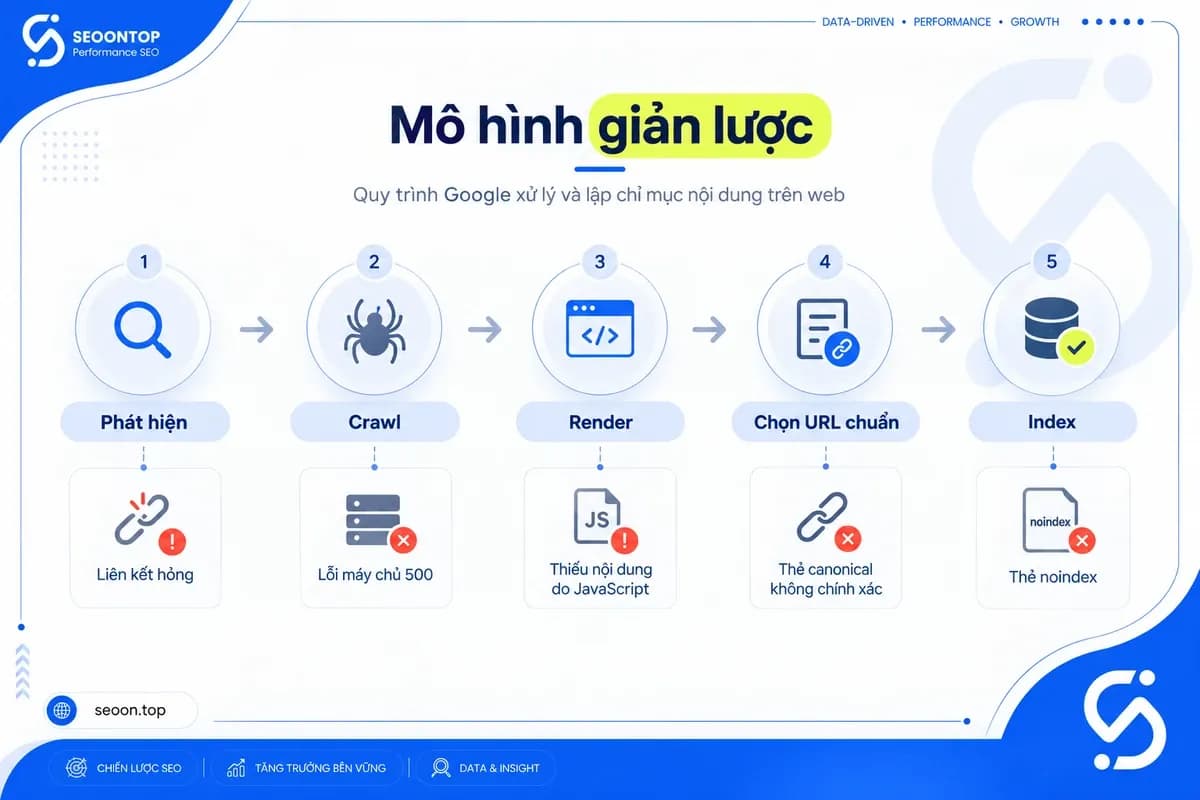
[Ảnh: Sơ đồ năm bước; ví dụ tương ứng gồm thiếu liên kết, lỗi 500, thiếu nội dung JavaScript, canonical sai, noindex. Ghi “Mô hình giản lược, không phải chuỗi xử lý cứng”. Alt: Quy trình Google phát hiện, crawl và lập chỉ mục trang.]
Bảng tổng hợp các lỗi crawl và index thường gặp
Trạng thái/lỗi | Nhóm | Khả năng cần kiểm tra | Cần sửa? | Ưu tiên | Xử lý chính |
|---|---|---|---|---|---|
Crawl | Máy chủ lỗi | Có | Khẩn nếu kéo dài | Kiểm tra hạ tầng | |
DNS error | Kết nối | Phân giải tên miền | Có | Khẩn nếu kéo dài | Kiểm tra DNS |
Crawl | Quy tắc Disallow | Nếu chặn nhầm | Cao | Chỉnh phạm vi chặn | |
Truy cập | Trang mất, link sai | Tùy mục đích | Tùy URL | Sửa link hoặc giữ 404 | |
Xử lý | Trang giống trang lỗi | Nếu ngoài ý muốn | Cao với URL chính | Sửa nội dung/phản hồi | |
Redirect error | Crawl | Vòng lặp, chuỗi lỗi | Có | Cao | Sửa chuyển hướng |
Index | Chỉ thị noindex | Nếu ngoài ý muốn | Cao | Xóa chỉ thị không phù hợp | |
Chưa crawl | Liên kết, server | Cần điều tra | Tùy URL | Rà khả năng tiếp cận | |
Chưa index | Nội dung, xử lý | Cần điều tra | Tùy URL | Kiểm tra tổng hợp | |
Trùng lặp | Chưa chọn URL chuẩn | Nếu chưa đúng mục đích | Tùy URL | Đồng bộ canonical | |
Duplicate, Google chose different canonical than user | Trùng lặp | Tín hiệu bất nhất | Nếu chọn sai | Cao với URL chính | Đối chiếu hai URL |
Trang thay thế | Canonical hợp lệ | Thường không | Theo dõi | Kiểm tra URL chuẩn |
DNS là lỗi hạ tầng, không phải mã HTTP hoặc nhãn luôn xuất hiện trong Pages. Không bỏ qua sự cố 5xx/DNS kéo dài vì URL mẫu ít giá trị.
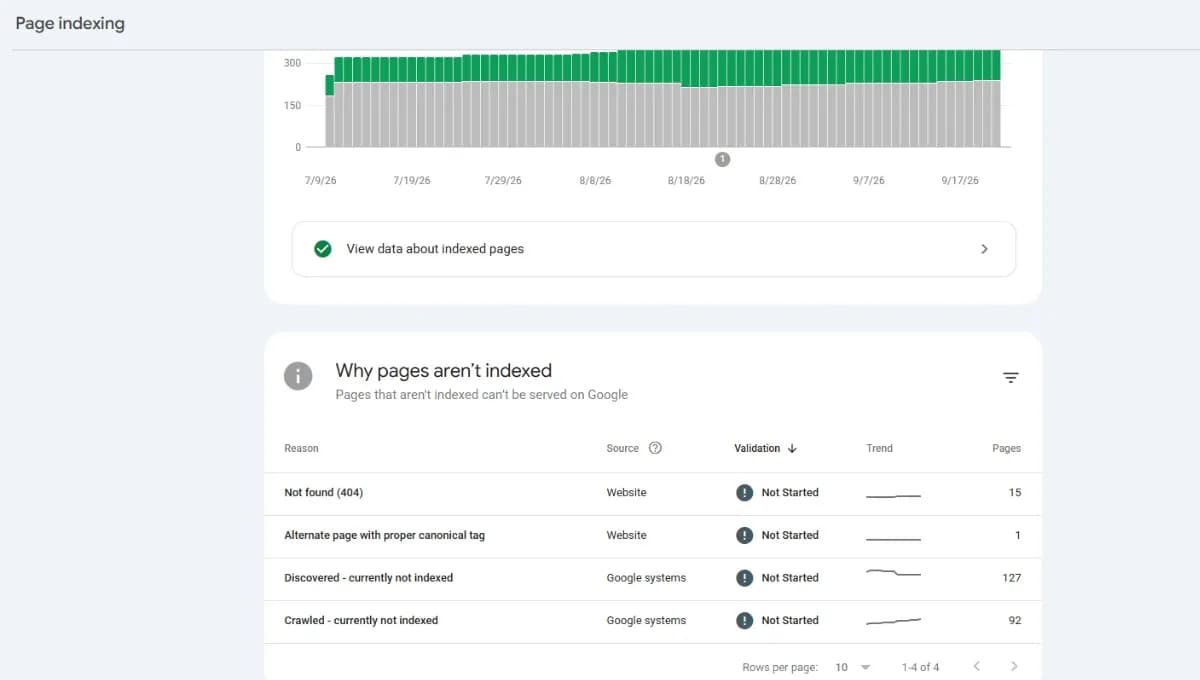
Tên trạng thái dựa trên Page indexing report của Search Console Help. Phần tiếp theo hướng dẫn chẩn đoán từng nhóm.
Các lỗi crawl phổ biến và cách khắc phục
Kiểm tra phản hồi thực tế trước khi chỉnh nội dung. Google có thể bị chặn, hoặc tải được trang nhưng không đọc đủ thông tin.
Server error 5xx và lỗi DNS
Các mã 500/502/503/504 chỉ ra vấn đề phía máy chủ hoặc hệ thống trung gian. DNS là lỗi phân giải tên miền, có thể xảy ra trước phản hồi HTTP.
Bạn nên đối chiếu với Crawl Stats; hosting và developer kiểm tra máy chủ, ứng dụng, CDN (mạng phân phối nội dung). Lỗi kéo dài có thể giảm crawl và ảnh hưởng index.
Lưu ý: Không mặc định nâng hosting trước khi xác minh nguyên nhân.
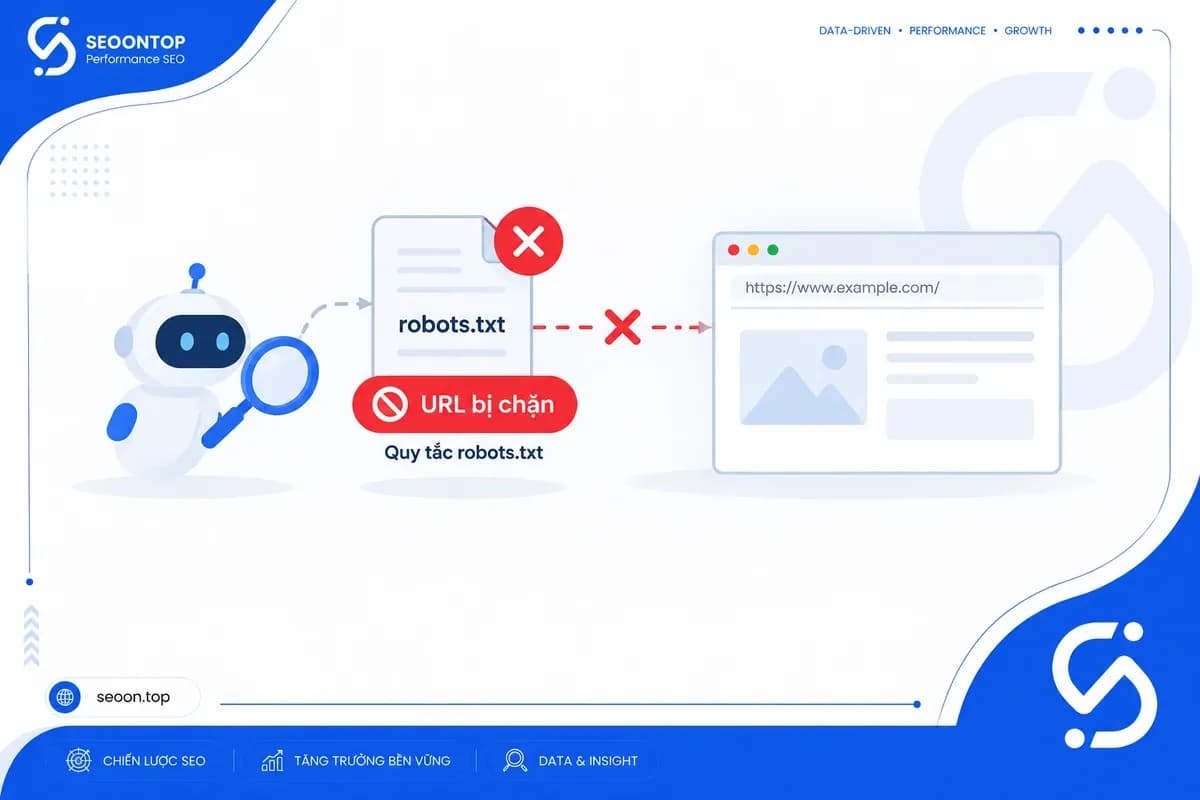
Blocked by robots.txt hoặc robots.txt không truy cập được
Disallow: / có thể chặn toàn website nếu áp dụng cho Googlebot. Bạn cần kiểm tra nhóm bot và đường dẫn trước khi gỡ chặn.
Bên cạnh đó, cần phân biệt rõ giữa quy tắc chặn URL và sự cố không tải được tệp robots.txt. Theo tài liệu chính thức, các lỗi mạng hoặc mã trạng thái máy chủ 5xx có thể làm gián đoạn quá trình thu thập dữ liệu (crawl), trong khi phản hồi 404 của chính tệp robots.txt không đồng nghĩa với việc website đang bị chặn.
Lỗi 404 và liên kết nội bộ hỏng
Khi các trang quan trọng bị xóa nhầm hoặc các liên kết nội bộ vẫn trỏ đến các URL không còn tồn tại, bạn cần khôi phục lại trang, đồng thời cập nhật đường dẫn và tệp sitemap.
- Bạn nên duy trì mã phản hồi 404 hoặc 410 nếu việc xóa trang là có chủ đích.
- Chỉ sử dụng chuyển hướng vĩnh viễn (301) khi có trang thay thế mang nội dung tương đương.
- Tuyệt đối không chuyển hướng hàng loạt mọi URL hỏng về trang chủ — ngay cả khi các URL đó có chứa liên kết từ các trang web bên ngoài.
Soft 404
Soft 404 là trạng thái xảy ra khi Google đánh giá một trang web trông giống như trang lỗi hoặc không chứa nội dung thực sự hữu ích, mặc dù máy chủ vẫn trả về mã phản hồi thành công (200 OK) và Google đã tải URL đó hoàn tất.
Ví dụ minh họa: Trang thiết bị ngừng phân phối chỉ còn thông báo trống. Nếu còn giá trị, bổ sung tài liệu; nếu xóa, trả 404/410 hoặc chuyển hướng tương đương. Không phải mọi trang ngắn đều là soft 404.
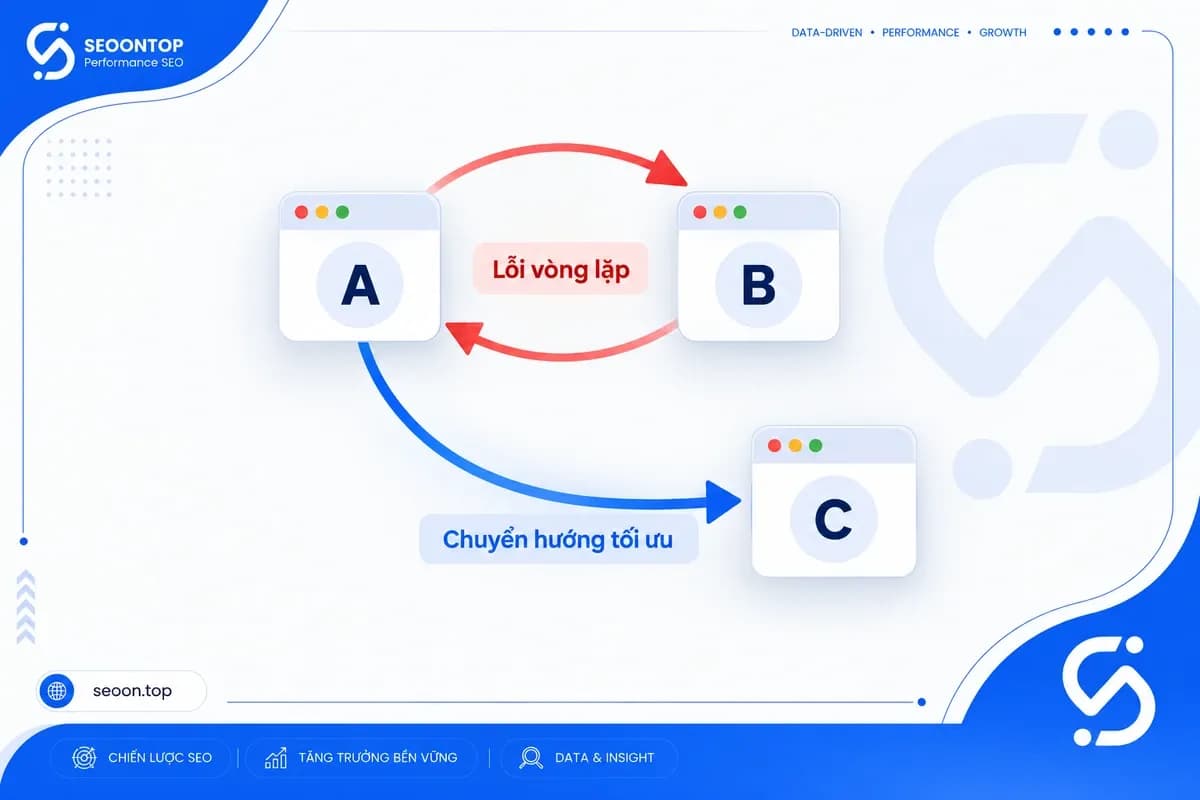
Redirect chain và redirect loop
- Redirect chain (chuỗi chuyển hướng): Là chuỗi chuyển hướng dài qua nhiều bước (A → B → C)
- Redirect loop (vòng lặp chuyển hướng): Là tình trạng chuyển hướng vòng quanh (A → B → A).
Lưu ý: Không phải mọi chuỗi chuyển hướng đều gây ra lỗi crawl, nhưng chúng làm lãng phí tài nguyên thu thập dữ liệu.
Ví dụ thực tế: Sau khi tái cấu trúc hệ thống, các URL giải pháp cũ có thể phải chuyển hướng qua nhiều bước trung gian. Đội ngũ phát triển nên rút gọn trực tiếp về URL đích phù hợp, trong khi chuyên gia SEO cần cập nhật lại liên kết nội bộ và sitemap. Đích đến cuối cùng bắt buộc phải trả về mã 200, không chứa thẻ noindex và có khai báo thẻ canonical chính xác.
Googlebot bị chặn bởi 403, firewall hoặc CDN
Trường hợp người dùng truy cập bình thường nhưng bot có thể nhận mã lỗi 403 hoặc 429. Khi đó, đội ngũ bảo mật cần kiểm tra lại các quy tắc của tường lửa ứng dụng web (WAF).
Tiến hành xác minh bot dựa theo tài liệu chính thức về cách kiểm tra bot của Google thay vì chỉ cho phép truy cập dựa trên tên user-agent, đồng thời tránh việc tắt toàn bộ hệ thống bảo vệ website.
Nội dung JavaScript không được render đầy đủ
Tải HTML thành công không bảo đảm đọc được nội dung chính. Kiểm tra HTML đã render trong URL Inspection. Nếu thiếu nội dung hoặc link thiết yếu, chuyển developer xử lý. SSR (render phía máy chủ) là phương án cần đánh giá, không phải yêu cầu mặc định.
Các lỗi và trạng thái index thường gặp trong Google Search Console
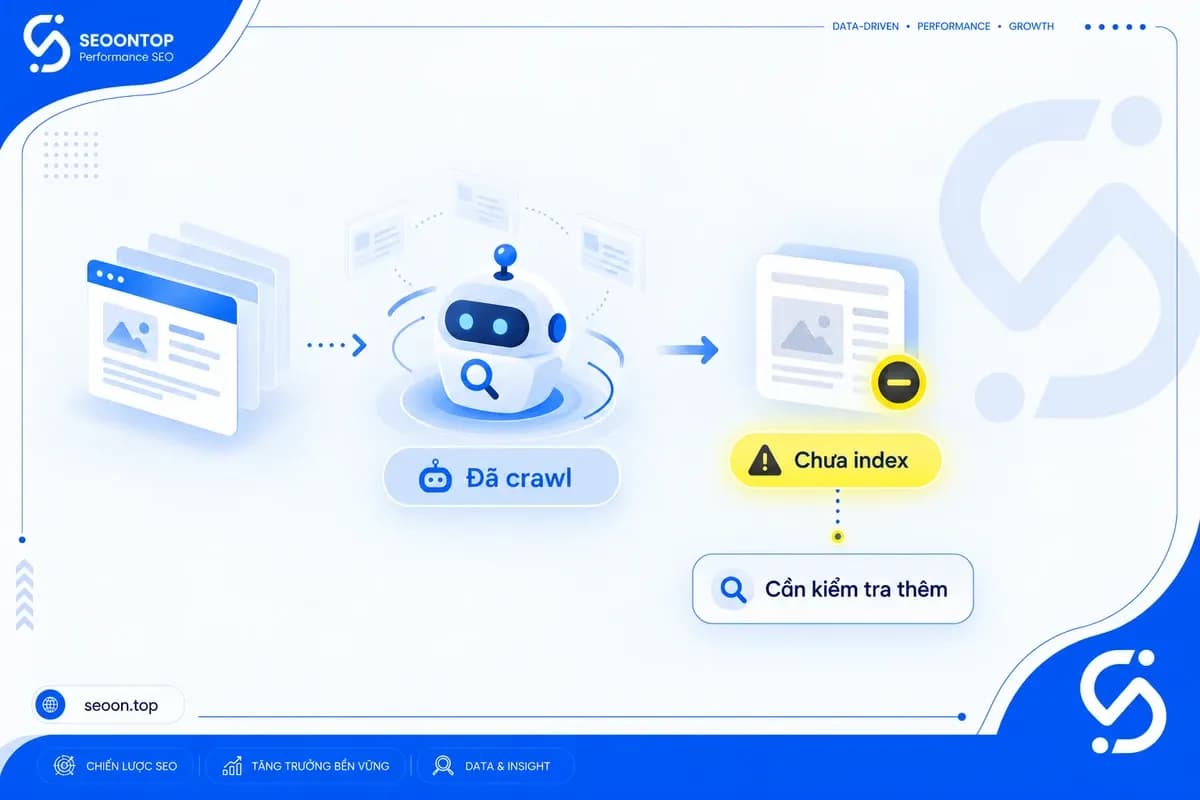
Excluded by 'noindex' tag
Trang đang có chỉ thị noindex. Hãy kiểm tra cả thẻ meta robots trong HTML và X-Robots-Tag trong HTTP header.
Ví dụ: Website phần mềm chuyển sang CMS (hệ quản trị nội dung) mới, nhưng trang giải pháp vẫn còn noindex từ môi trường thử nghiệm.
Nếu muốn trang được index, hãy gỡ noindex rồi để Google crawl lại. Tránh chặn các URL này trong tệp robots.txt, vì khi đó Googlebot không thể truy cập trang và do đó không thể đọc được thẻ noindex.
Discovered – currently not indexed
Google đã biết URL, thường qua liên kết hoặc sitemap, nhưng chưa crawl. Bản thân trạng thái này không cho biết lý do. Hãy kiểm tra:
- URL đã có liên kết nội bộ phù hợp chưa?
- Sitemap có liệt kê đúng URL không?
- Máy chủ có phản hồi ổn định không?
- Website có sinh ra quá nhiều URL không cần thiết không?
Crawl budget (ngân sách thu thập) thường chỉ đáng lo với website lớn, cập nhật liên tục hoặc có nhiều URL giá trị thấp.
Crawled – currently not indexed
Google đã crawl nhưng chưa index URL. Trang có thể được index sau này, cũng có thể không. Trạng thái này không chứng minh nội dung kém, và cũng không có nghĩa Google đã render đầy đủ trang. Hãy xử lý theo 4 bước:
- Kiểm tra mốc thời gian: So ngày crawl gần nhất với ngày bạn sửa trang.
- Đánh giá giá trị: Trang có đáp ứng một nhu cầu riêng, giúp ích cho người dùng hoặc hỗ trợ bán hàng không?
- Rà soát kỹ thuật: Xem nội dung sau khi render, các bản trùng lặp và canonical.
- Sửa có căn cứ: Cải thiện nội dung, hoặc gộp trang nếu thật sự phù hợp.
Đừng xóa hay noindex hàng loạt chỉ vì trang ít truy cập. Hai trang cùng mục đích tìm kiếm chưa chắc đã trùng nội dung.
Duplicate without user-selected canonical
Google thấy các trang có nội dung trùng hoặc gần giống nhau, nhưng bạn chưa khai báo URL chuẩn.
Hãy chọn một phiên bản đại diện và đặt self-canonical (canonical trỏ về chính nó) cho trang đó. Sau đó cho canonical trên các bản trùng, sitemap và liên kết nội bộ cùng trỏ về URL này.
Ví dụ: catalogue máy công nghiệp có nhiều URL tham số cùng hiển thị một nội dung. Chỉ thêm self-canonical là chưa đủ nếu các tín hiệu khác vẫn mâu thuẫn.
Duplicate, Google chose different canonical than user
Google chọn một URL chuẩn khác với URL bạn khai báo. Canonical là tín hiệu mạnh, nhưng Google không bắt buộc phải làm theo.
So sánh User-declared canonical với Google-selected canonical, rồi kiểm tra nội dung hai trang, chuyển hướng, sitemap và liên kết nội bộ.
Nếu Google đã chọn đúng phiên bản đại diện thì có thể không cần sửa. Không đặt canonical giữa những trang có nội dung khác nhau chỉ vì chúng cùng chủ đề.
Alternate page with proper canonical
Thường không cần xử lý: Đây là trang thay thế và đã có canonical đúng. Chỉ can thiệp khi canonical bị khai báo sai, hoặc khi trang này cần xuất hiện riêng trên kết quả tìm kiếm.
Lưu ý: Trạng thái này không xác nhận URL chuẩn đã được index, nên hãy kiểm tra riêng URL chuẩn.
Orphan page và URL nằm quá sâu
Orphan page (trang mồ côi) là trang không có liên kết nội bộ nào trỏ tới. Đây là vấn đề cấu trúc website, không phải một trạng thái trong GSC.
Hãy thêm liên kết theo ngữ cảnh từ trang giải pháp, trang danh mục hoặc tài liệu liên quan. Không nhất thiết trang nào cũng phải nằm trong 3 click, và tránh thêm liên kết hàng loạt khi chúng không giúp ích cho người đọc..
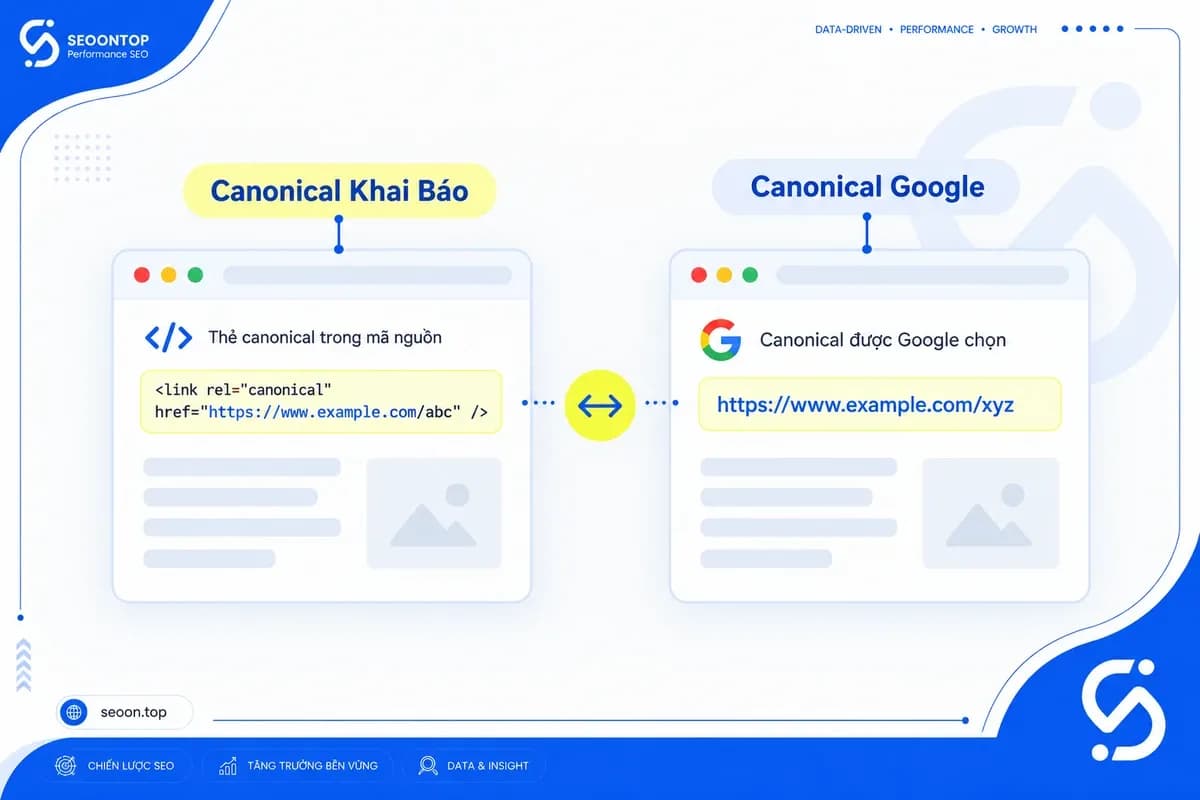
[Ảnh: Minh họa hai trường canonical khai báo và canonical Google chọn; che thông tin nhạy cảm nếu dùng ảnh thật. Alt: So sánh URL chuẩn khai báo với URL chuẩn Google lựa chọn.]
Quy trình kiểm tra lỗi bằng Google Search Console
- Mở Pages để xác định nhóm trạng thái.
- Dùng URL Inspection kiểm tra URL đại diện.
- Xem Crawl Stats để đánh giá truy cập.
- Dùng crawler ngoài GSC để đối chiếu hàng loạt.
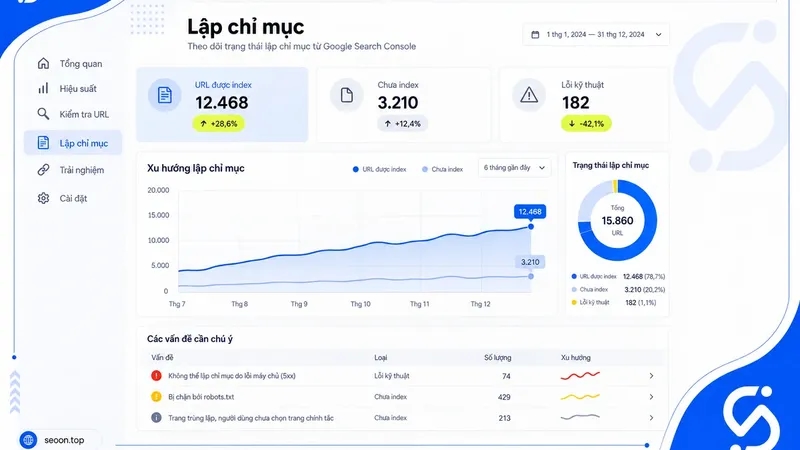
Mở báo cáo Pages trong mục Indexing
Trong Google Search Console, vào Indexing → Pages; tên hiển thị có thể khác theo ngôn ngữ giao diện.
Sau đó xem lý do chưa index, URL mẫu và mốc biến động. Danh sách mẫu không nhất thiết chứa toàn bộ URL. Lúc này bạn hãy ghi nhóm trang bị ảnh hưởng, không chỉ tổng số.
Kiểm tra URL bằng URL Inspection
Chọn URL đại diện mỗi nhóm. Đọc trạng thái, Last crawl, quyền crawl/index nếu có và hai trường canonical. Sau đó bạn chạy Test live URL.
Dữ liệu đã lưu: Thông tin Google từng ghi nhận, có thể chưa phản ánh bản sửa.Live Test: Kiểm tra khả năng truy cập và xử lý hiện tại; không xác nhận chắc chắn URL sẽ index hoặc cung cấp mọi kết luận của hệ thống lập chỉ mục.
Phân biệt này được nêu trong URL Inspection tool của Search Console Help.
Kiểm tra Crawl Stats
Bạn vào Settings → Crawl Stats khi báo cáo khả dụng. Xem trạng thái máy chủ, mã phản hồi, thời gian phản hồi và biến động yêu cầu.
Request tăng không chứng minh Google đã crawl đủ URL quan trọng.
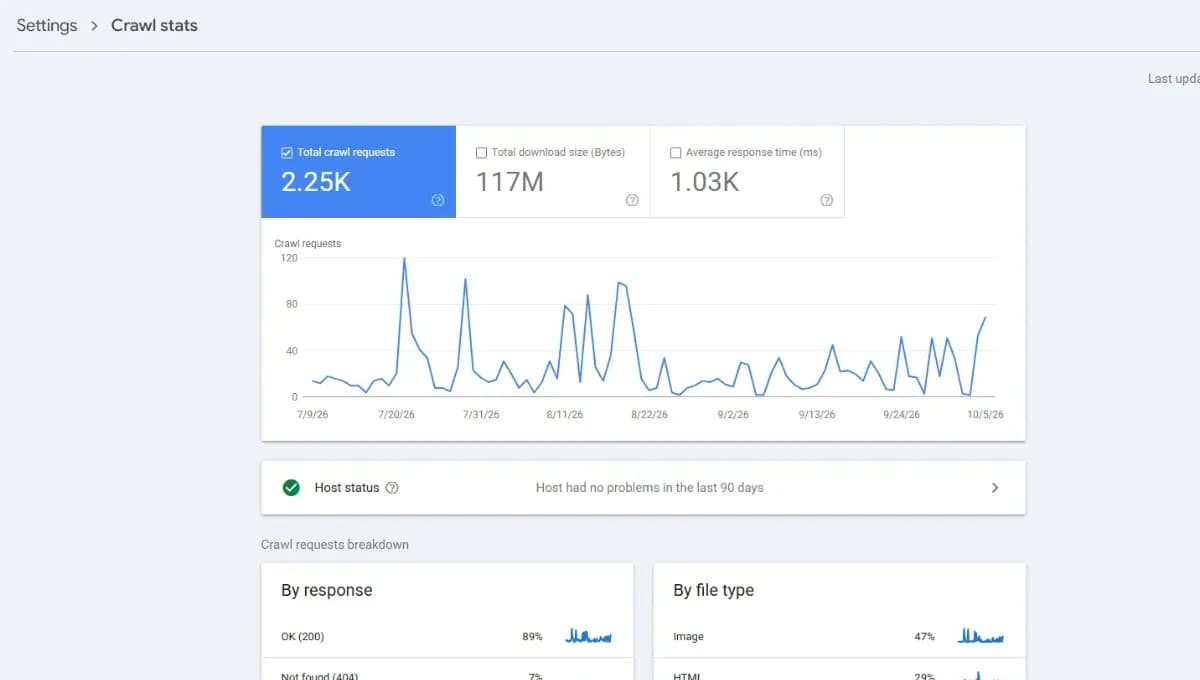
Dùng công cụ crawl website kiểm tra hàng loạt
Dùng Screaming Frog hoặc công cụ tương đương để rà status, noindex, canonical, redirect, link và sitemap. Crawler bên thứ ba không mô phỏng hoàn toàn Googlebot. Server logs (nhật ký truy cập máy chủ) là lựa chọn nâng cao khi cần xác minh truy cập thực tế.
Thứ tự ưu tiên xử lý lỗi crawl và index
Ưu tiên theo giá trị URL × phạm vi ảnh hưởng, kết hợp thời gian kéo dài.
Mức khẩn cấp
Xử lý trước: 5xx/DNS kéo dài, robots/noindex ngoài ý muốn diện rộng, WAF chặn bot, vòng lặp sau chuyển website hoặc canonical sai hàng loạt.
Mức ưu tiên cao
Ưu tiên trang giải pháp, yêu cầu demo, catalogue và nội dung tạo khách hàng tiềm năng. Rà liên kết nội bộ, sitemap sai trên nhóm này.
Trang demo đang tạo liên hệ quan trọng hơn nhiều URL tham số không cần index. Tuy nhiên, Crawled – currently not indexed vẫn cần điều tra trước khi kết luận.
Theo dõi hoặc không cần sửa
Giữ 404/410 hợp lệ, noindex chủ đích và trang thay thế canonical đúng, nếu không ảnh hưởng URL cần index.
Ma trận tác động kinh doanh
Giá trị URL | Phạm vi | Ví dụ | Ưu tiên |
|---|---|---|---|
Cao | Diện rộng | Noindex toàn nhóm giải pháp | Khẩn cấp |
Cao | Riêng lẻ | Trang demo lỗi | Cao |
Thấp | Diện rộng | URL tham số | Nâng mức nếu gây quá tải |
Thấp | Riêng lẻ | Trang xóa đúng | Theo dõi |
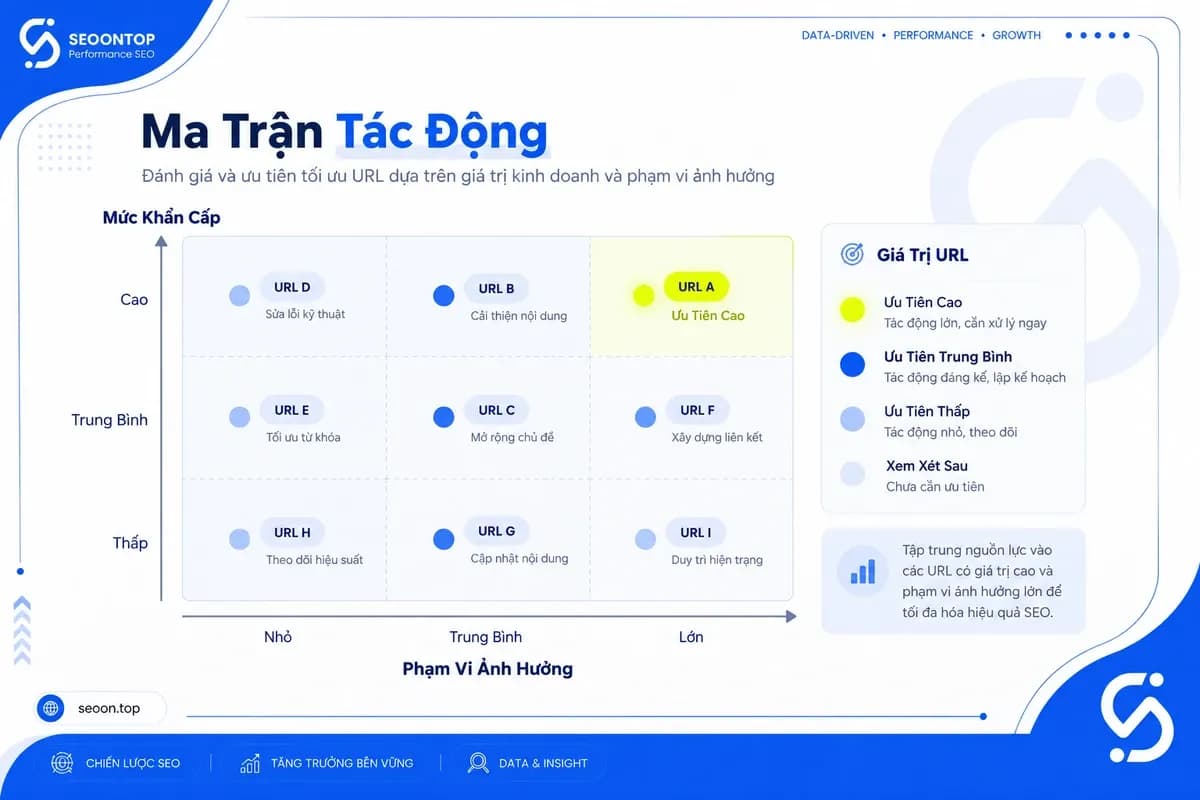
Checklist nghiệm thu sau khi khắc phục lỗi crawl và index
Bản sửa kỹ thuật đạt khác Google đã cập nhật trạng thái. Dùng checklist này để nghiệm thu riêng hai kết quả.
Kiểm tra kỹ thuật tại URL
- Mã phản hồi đúng mục đích giữ, chuyển hướng hoặc xóa.
- URL cần crawl không bị robots.txt/WAF chặn nhầm.
- URL cần index không còn noindex trong meta/header.
- Canonical đúng phiên bản đại diện.
- Không còn loop; chain thừa đã rút gọn.
- Nội dung chính render được, không giống trang lỗi.
Kiểm tra sitemap và internal link
- Sitemap XML thông thường chứa URL chuẩn, trả 200, cần index.
- URL 404, redirect, noindex ngoài mục tiêu đã loại khỏi sitemap.
- Liên kết nội bộ trỏ trực tiếp đến đích phù hợp.
- URL quan trọng có link theo ngữ cảnh; danh mục/đường dẫn điều hướng hoạt động đúng.
Xác minh trong GSC
- Live Test không tái hiện lỗi trên URL mẫu.
- Đã cân nhắc Request Indexing cho URL quan trọng; không bắt buộc.
- Dùng Validate Fix khi được hỗ trợ và nhóm lỗi đã sửa.
- Theo dõi dữ liệu đã lưu, Pages, Crawl Stats khi cập nhật.
- Lưu ngày sửa, người phụ trách, bằng chứng; không gửi yêu cầu lặp vô ích.
Điều kiện chuyển sang audit chuyên sâu
Cần kiểm tra sâu khi lỗi lan nhiều mẫu trang; traffic giảm sau chuyển website chưa rõ nguyên nhân; vấn đề liên quan server, CDN, JavaScript hoặc URL tham số.
Dữ liệu GSC và crawler khác nhau chưa chứng minh có lỗi. Bạn hãy đối chiếu thời điểm, phạm vi trước.
Mẫu giao việc: URL/nhóm URL — Mục đích index — Dấu hiệu — Nguyên nhân xác minh — Việc sửa — Người phụ trách — Ngày triển khai — Live Test — Trạng thái GSC — Bằng chứng.
Câu hỏi thường gặp
Lỗi Crawl và lỗi Index khác nhau như thế nào?
Lỗi Crawl xảy ra khi Googlebot không thể truy cập hoặc tải dữ liệu từ trang web của bạn do các rào cản kỹ thuật. Trong khi đó, lỗi hoặc trạng thái Index xuất hiện khi Googlebot đã truy cập thành công nhưng quyết định không đưa trang vào chỉ mục tìm kiếm vì lý do cấu hình kỹ thuật hoặc chất lượng nội dung.
Làm thế nào để biết trang web có đang gặp lỗi thu thập dữ liệu?
Bạn có thể kiểm tra trực tiếp trong Google Search Console tại mục Pages (hoặc Indexing). Các báo cáo tại đây sẽ hiển thị chi tiết các URL không được lập chỉ mục kèm theo mã lỗi cụ thể như Server error (5xx), 404 Not Found, hoặc Blocked by robots.txt để bạn có hướng xử lý kịp thời.
Tại sao trạng thái "Crawled – currently not indexed" lại phổ biến?
Trạng thái này cho biết Google đã tải và đọc nội dung trang nhưng từ chối lập chỉ mục vì nội dung được đánh giá là chưa đủ giá trị, bị trùng lặp hoặc mỏng (thin content). Để khắc phục, bạn cần bổ sung thông tin độc bản, chuyên sâu hoặc hợp nhất các trang có nội dung tương đồng.
Có cần gửi "Request Indexing" cho mọi trang đã sửa lỗi không?
Không nhất thiết. Việc yêu cầu lập chỉ mục (Request Indexing) chỉ nên dùng cho các trang quan trọng cần Google cập nhật ngay. Đối với phần lớn các lỗi đã được xử lý, Googlebot sẽ tự động thu thập lại dữ liệu khi nó quay lại website theo lịch trình định kỳ của hệ thống.
Lỗi Soft 404 là gì và cách xử lý ra sao?
Soft 404 là khi trang không tồn tại nhưng server vẫn trả về mã trạng thái 200 OK. Để khắc phục, bạn cần cấu hình lại máy chủ để trả về đúng mã 404 (Not Found) hoặc 410 (Gone) cho các URL không tồn tại, hoặc thực hiện chuyển hướng 301 nếu có trang thay thế phù hợp.
Việc website bị chặn bởi robots.txt có gây mất chỉ mục không?
Có, nếu bạn vô tình chặn các tệp tin quan trọng hoặc toàn bộ thư mục nội dung trong robots.txt, Googlebot sẽ không thể tiếp cận và hiểu được cấu trúc trang. Bạn cần kiểm tra kỹ tệp này để đảm bảo không chặn nhầm các tài nguyên thiết yếu giúp Google hiểu và render nội dung trang web.
Xem thêm:
- Website không index: Nguyên nhân và cách khắc phục nhanh nhất
- Google Index là gì? Hướng dẫn cách kiểm tra và lập chỉ mục
- URL is unknown to Google: Nguyên nhân và 6 bước xử lý hiệu quả
Kết luận
Xử lý các lỗi crawl và index thường gặp bắt đầu từ việc xác định URL nào cần xuất hiện trên Google. Tiếp theo, phân biệt vấn đề truy cập với trạng thái lập chỉ mục, xác minh nguyên nhân và ưu tiên trang quan trọng. Không cần biến mọi URL “Not indexed” thành nhiệm vụ sửa lỗi.
Sau triển khai, hãy đối chiếu dữ liệu đã lưu với Live Test và theo dõi lần Google cập nhật tiếp theo. Request Indexing hay Validate Fix không bảo đảm index ngay; cũng không có thời gian xử lý cố định cho mọi website. Hãy sử dụng checklist và mẫu giao việc trong bài để thống nhất trách nhiệm, bằng chứng và điều kiện nghiệm thu.