Crawl Depth là gì? Cách kiểm tra và tối ưu độ sâu trang trong SEO
Crawl Depth là gì?
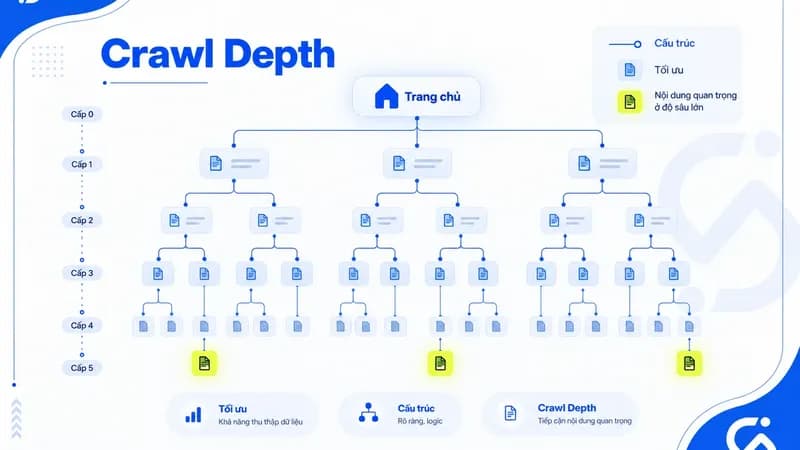
Crawl Depth (hay Click depth) đo đường đi liên kết ngắn nhất đến một trang, chứ không phải số trang Googlebot thực tế đã ghé thăm—bởi Googlebot có thể phát hiện URL từ nhiều nguồn khác ngoài trang chủ. Trong bài viết này, trang chủ được quy ước là Depth 0, chuẩn theo cách đo từ điểm xuất phát của công cụ Screaming Frog.
Ví dụ các cấp độ sâu
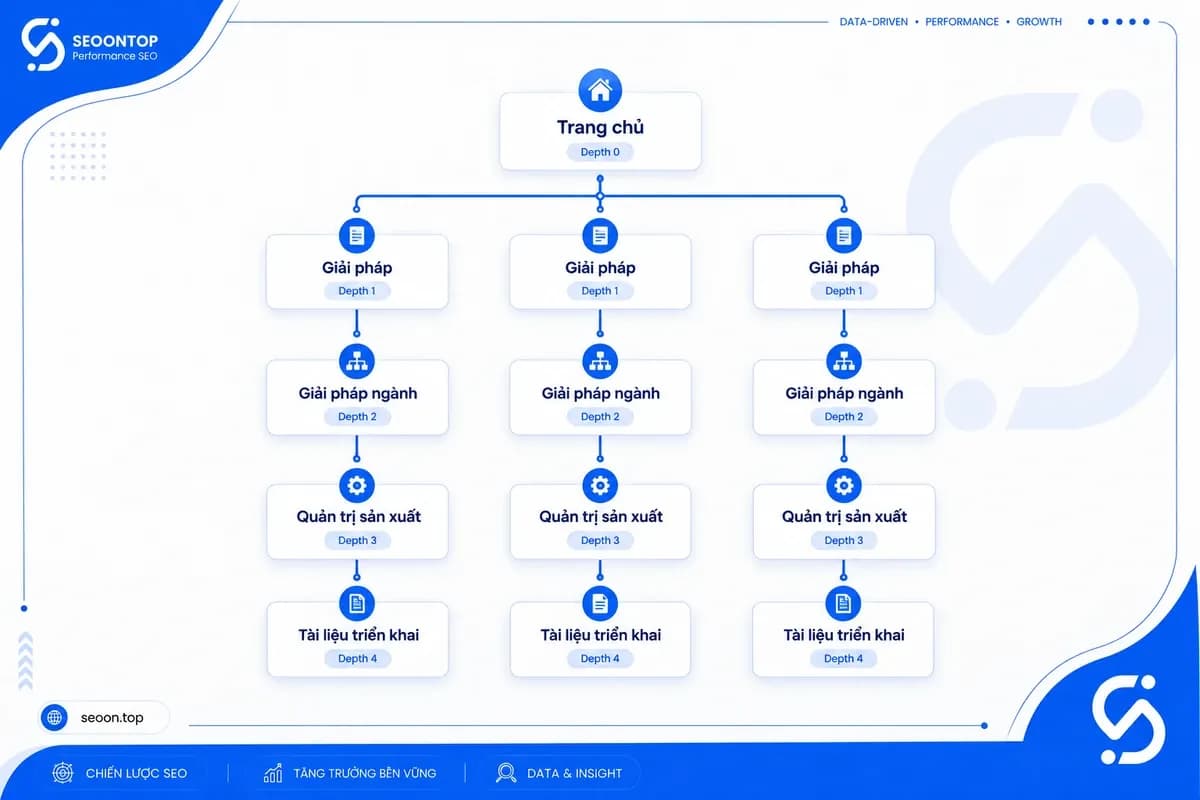
Ví dụ minh họa cho website phần mềm quản trị:
Trang chủ                         Depth 0
└── Giải pháp                     Depth 1
    └── Giải pháp ngành           Depth 2
        └── Quản trị sản xuất     Depth 3
            └── Tài liệu triển khai   Depth 4
Giả định mỗi nhánh là một liên kết và không có đường đi ngắn hơn.
Chỉ số này phản ánh điều gì?
- Khoảng cách tiếp cận URL trong phạm vi crawl.
- Vị trí tương đối của trang trong hệ thống điều hướng.
- Những URL cần kiểm tra thêm về liên kết.
Crawl Depth không phản ánh toàn bộ chất lượng trang. Một URL không xác định được độ sâu cũng chưa chắc đã là trang mồ côi (orphan page - trang không có liên kết nội bộ trỏ đến).
Crawl Depth được tính như thế nào?
“Số click từ trang chủ” là cách diễn đạt phổ biến của Crawl Depth, nhưng phép đo thực chất đếm bước liên kết. Cụ thể khi có nhiều đường đến một trang, công cụ lấy shortest path (đường đi ngắn nhất) mà nó phát hiện.
Nếu trang giải pháp đang ở Depth 3 được liên kết trực tiếp từ trang chủ, Depth mới là 1.
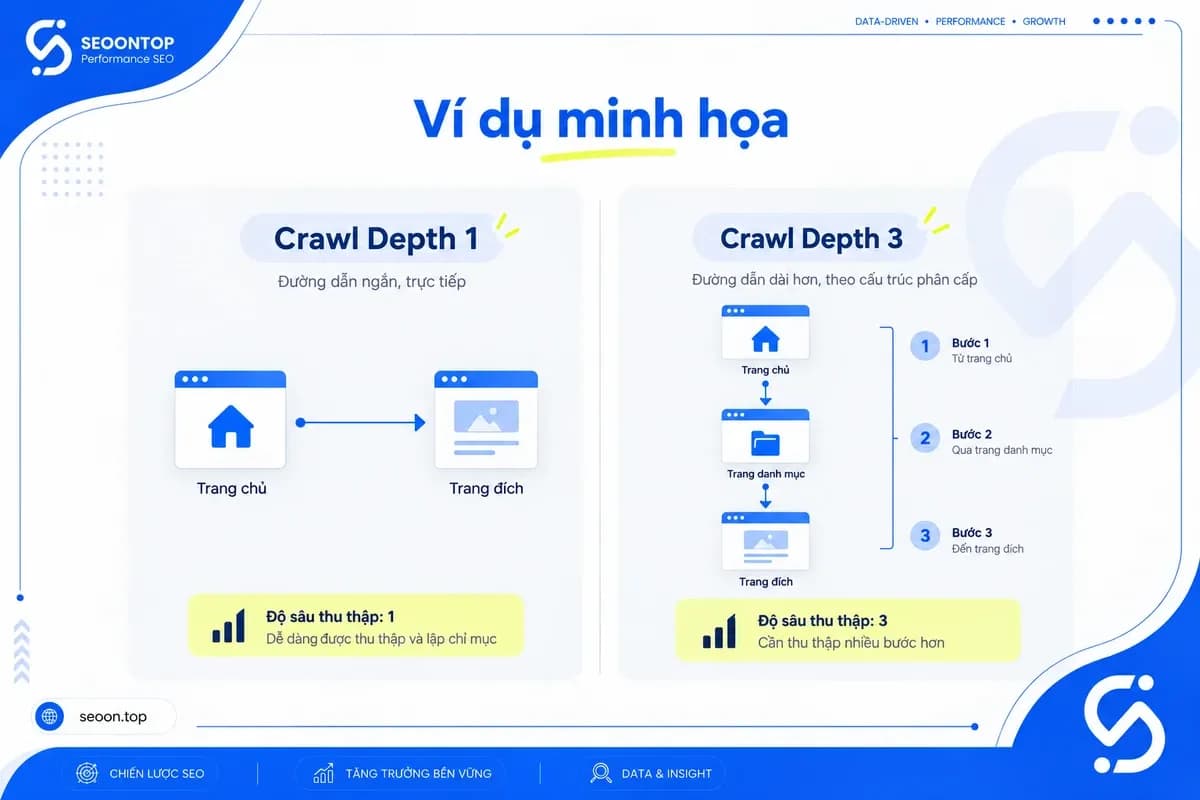
Crawl Depth khác độ sâu đường dẫn URL
URL Folder Depth (độ sâu thư mục URL) mô tả cấu trúc đường dẫn, không phải khoảng cách liên kết. Bảng dưới đếm thành phần không rỗng sau tên miền:
Đường dẫn tương đối | Số thành phần | Đường truy cập ngắn nhất | Crawl Depth |
|---|---|---|---|
| 3 | Trang chủ → trang đích | 1 |
| 1 | Trang chủ → giải pháp → ngành → trang đích | 3 |
Yếu tố ảnh hưởng phép đo
Các yếu tố ảnh hưởng đến phép đo Crawl Depth:
- Điểm bắt đầu và phạm vi thu thập: Giới hạn URL hoặc thư mục khi crawl có thể làm sót các liên kết trỏ đến trang.
- Khả năng truy cập kỹ thuật: Yêu cầu đăng nhập hoặc việc xử lý (render) nội dung JavaScript sẽ quyết định crawler có phát hiện được liên kết hay không.
- Nguồn phát hiện bổ sung: Sitemap hỗ trợ tìm kiếm URL nhưng không chứng minh trang đó có liên kết nội bộ trỏ về từ trang chủ.
- Cấu hình điều hướng bot: File robots.txt giúp kiểm soát quyền crawl URL, trong khi thuộc tính rel="nofollow" được Google coi là một gợi ý và xử lý tùy thuộc vào thiết lập của crawler.
Crawl Depth khác gì với Page Depth, Crawl Budget và Crawlability?
Các thuật ngữ này trả lời những câu hỏi khác nhau. Bạn không nên dùng một chỉ số để kết luận toàn bộ khả năng thu thập dữ liệu.
Thuật ngữ | Ý nghĩa | Cách đánh giá | Câu hỏi được trả lời |
|---|---|---|---|
Crawl Depth | Khoảng cách liên kết từ điểm bắt đầu | Crawl cấu trúc liên kết | Cần bao nhiêu bước? |
Page/Click Depth | Độ sâu trang trong ngữ cảnh kiến trúc | Kiểm tra định nghĩa công cụ | Trang cách điểm xuất phát bao xa? |
URL Depth | Độ sâu đường dẫn | Đếm thành phần đường dẫn | URL có mấy cấp? |
Ngân sách thu thập dữ liệu | Đối chiếu hoạt động và điều kiện crawl | Google có thể và muốn crawl bao nhiêu? | |
Crawlability | Khả năng được thu thập dữ liệu | Kiểm tra truy cập, liên kết, robots | Bot có thể đọc trang không? |
Page Depth có thể mang nghĩa khác tùy công cụ. Trong bảng, thuật ngữ này không chỉ số trang người dùng xem trong một phiên truy cập.
Theo hướng dẫn quản lý ngân sách thu thập dữ liệu (Crawl Budget) cho website lớn từ Google, khả năng crawl phụ thuộc vào nhu cầu và năng lực hệ thống, không phải là một hạn mức URL cố định. Đây là yếu tố đặc biệt quan trọng đối với các website quy mô lớn (như web phần mềm sở hữu nhiều tài liệu hoặc URL bộ lọc).
Lưu ý: Crawl Depth không trực tiếp quyết định ngân sách này, bởi thu thập dữ liệu (crawl), lập chỉ mục (index) và xếp hạng (ranking) là ba quá trình hoàn toàn riêng biệt.
Crawl Depth ảnh hưởng đến SEO như thế nào?
Độ sâu hữu ích nhất khi được dùng để tìm điểm nghẽn tiếp cận URL quan trọng. Nó không phải công cụ dự báo thứ hạng độc lập.
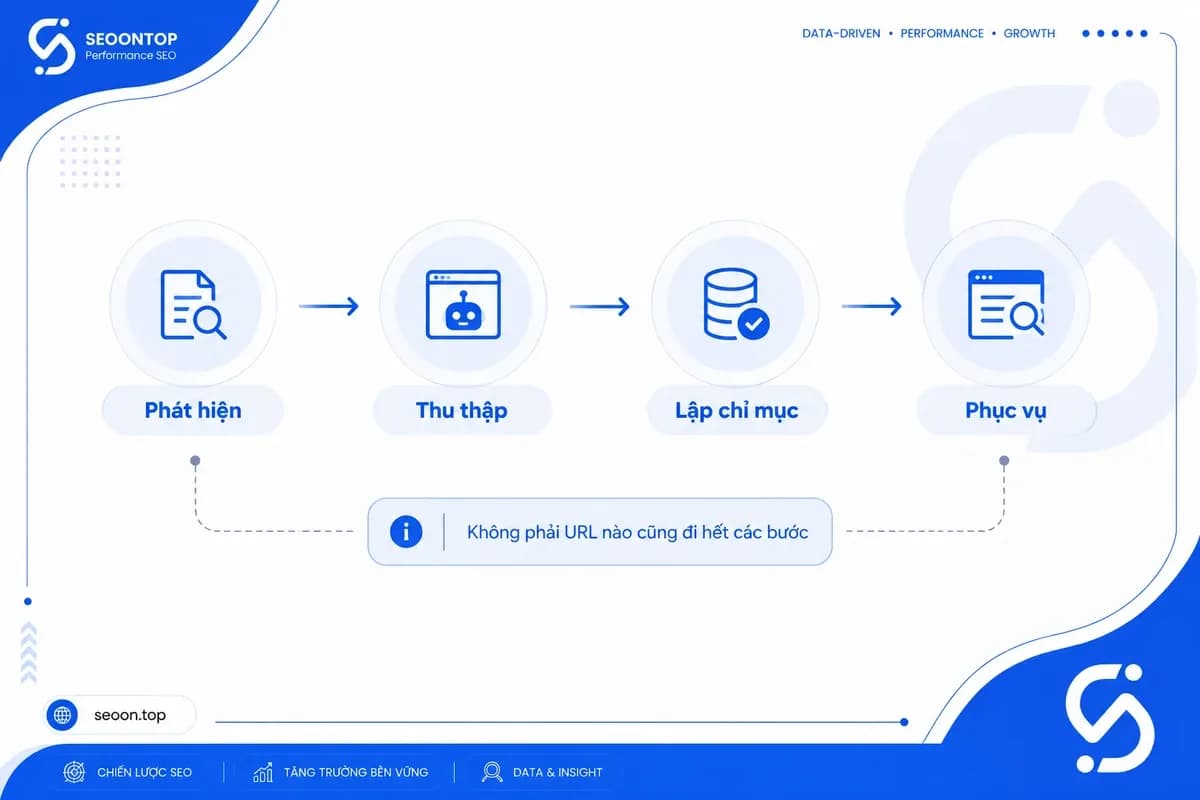
Phát hiện và thu thập dữ liệu
- Discovery (phát hiện URL) có thể đến từ liên kết, sitemap hoặc những URL Google đã biết.
- Crawling (thu thập dữ liệu) là bước truy cập để đọc nội dung.
Trang sâu, ít liên kết hữu ích có thể khó được tiếp cận hơn. Ví dụ, trang giải pháp ngành ở Depth 4 nhưng thiếu liên kết từ trang tổng hợp là điểm cần kiểm tra, chưa phải nguyên nhân chắc chắn gây mất khách hàng.
Phân phối tín hiệu PageRank
PageRank là thuật toán đánh giá độ uy tín của trang dựa trên các liên kết, trong đó hệ thống liên kết nội bộ đóng vai trò phân bổ sức mạnh giữa các trang. Dù vậy, Crawl Depth không phản ánh hoàn toàn lượng tín hiệu mà một trang nhận được, bởi không tồn tại một công thức hay tỷ lệ "hao hụt sức mạnh" cố định qua mỗi tầng độ sâu.
Trải nghiệm điều hướng
Trải nghiệm người dùng (UX) sẽ tốt hơn khi khách hàng dễ dàng tìm thấy các trang nội dung quan trọng. Tuy nhiên, việc rút ngắn khoảng cách truy cập cần đi đôi với tên nhãn điều hướng rõ ràng, tránh ôm đồm nhét tất cả URL vào thanh menu gây rối mắt.
Giới hạn đối với lập chỉ mục và thứ hạng
Crawl Depth thấp không đảm bảo 100% trang sẽ được lập chỉ mục. Ngoài độ sâu liên kết, bạn cần kiểm tra thêm các yếu tố quan trọng sau:
- Nội dung: Chất lượng bài viết có đạt chuẩn hay không.
- Kỹ thuật và cấu hình: Mã phản hồi HTTP, file robots.txt, chỉ thị noindex và khả năng xử lý JavaScript.
- Định danh URL: Thẻ canonical khai báo đúng URL đại diện.
Crawl Depth bao nhiêu là hợp lý?
Không có ngưỡng Crawl Depth cố định cho mọi website. Quy tắc 3 click chỉ là tham khảo khi thiết kế điều hướng, không phải tiêu chuẩn chất lượng của Google.
Gợi ý phân nhóm audit, không phải tiêu chuẩn chất lượng của Google:
Depth | Hướng đánh giá |
|---|---|
0 | Điểm bắt đầu đo, ở đây là trang chủ |
1 | Trang được liên kết trực tiếp |
2 | Kiểm tra tính hợp lý của nhóm trang |
3 | Đối chiếu vai trò và đường tiếp cận |
4+ | Kiểm tra nếu là URL ưu tiên |
Không xác định | Kiểm tra phạm vi, cấu hình trước khi kết luận mồ côi |
Các trang giải pháp chủ lực và nội dung thúc đẩy mua hàng cần được đặt ở vị trí dễ tiếp cận nhất. Trong khi tài liệu lưu trữ có thể nằm ở các tầng sâu hơn, những tài liệu kỹ thuật quan trọng vẫn phải được ưu tiên hiển thị sớm.
Mục tiêu cốt lõi là xây dựng một kiến trúc phẳng có chọn lọc—ưu tiên đúng trang thay vì máy móc ép mọi URL phải nằm ở Depth 1-3.
Cách kiểm tra Crawl Depth của website
Quy trình gồm năm bước:
- Crawl từ trang chủ.
- Xem và phân nhóm độ sâu.
- Đối chiếu URL quan trọng.
- Tìm URL orphan.
- Crawl lại để xác minh.
Crawl từ trang chủ
Bạn hãy tiến hành crawl dữ liệu từ trang chủ bằng các công cụ như Screaming Frog SEO Spider, Sitebulb hoặc Ahrefs Site Audit. Trong quá trình thiết lập, cần lưu ý ghi lại điểm bắt đầu, phạm vi, chế độ render (xử lý JavaScript) và các giới hạn crawl.
Tuy nhiên, hãy nhớ rằng kết quả từ các công cụ bên thứ ba này chỉ mang tính tham khảo và không phản ánh hoàn toàn chính xác cách Googlebot xử lý website của bạn.
Xem và phân nhóm
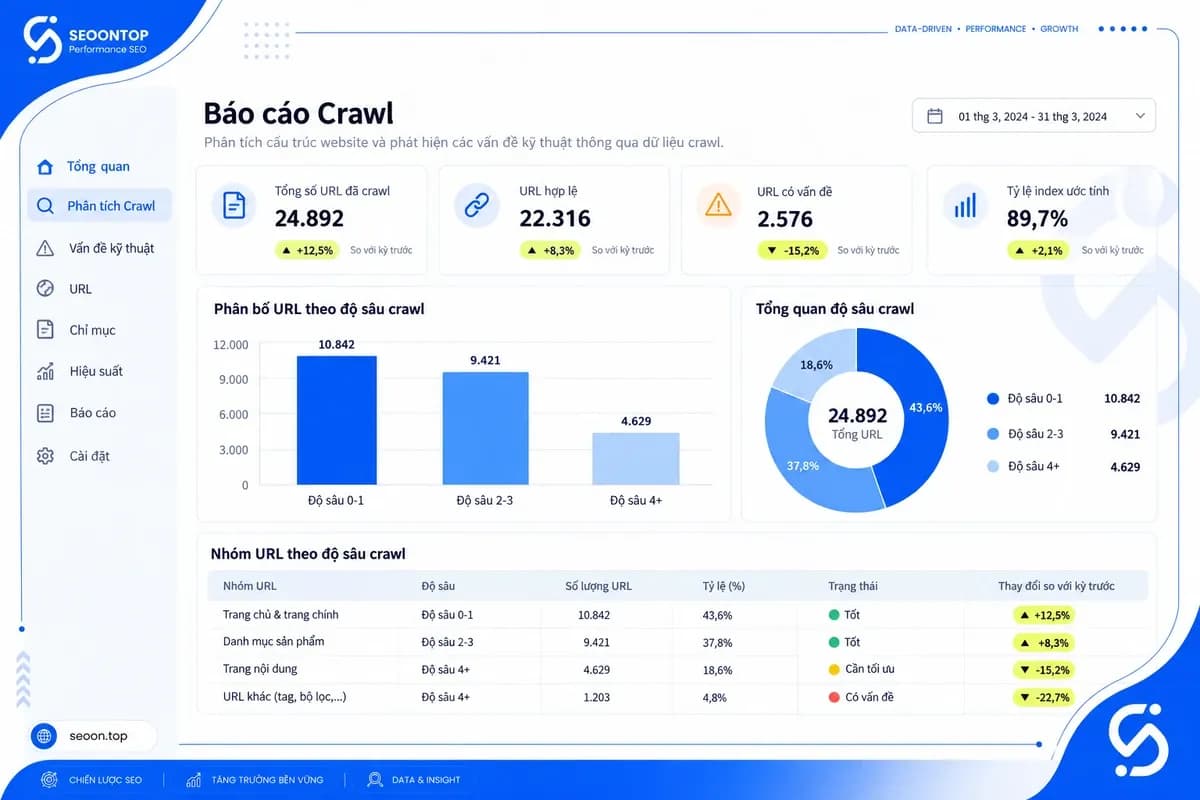
Tiếp đến, bạn xem trường Crawl Depth, chia nhóm 0–1, 2–3 và 4+ rồi giữ riêng URL không xác định độ sâu để kiểm tra.
Đối chiếu URL quan trọng
Bạn tập trung đối chiếu các trang mục tiêu SEO, trang tạo chuyển đổi và trang có backlink, đồng thời kết hợp thêm dữ liệu lượt nhấp, lượt hiển thị từ Google Search Console (GSC).
Lưu ý về GSC: GSC không hỗ trợ thống kê cột Depth toàn trang, doanh thu phát sinh hay toàn bộ lịch sử crawl chi tiết cho từng URL.
Tìm URL orphan
Để tìm, bạn so sánh kết quả crawl với sitemap, CMS, GA4 và GSC để tìm các URL nghi là orphan page (các URL vắng mặt trong dữ liệu crawl là đối tượng cần xác minh thêm).
Lưu ý: Tách riêng phép đo crawl từ trang chủ với việc nạp danh sách URL bổ sung; không coi GA4 hay GSC là nguồn tổng hợp đầy đủ 100% mọi URL trên website.
Crawl lại
Bạn giữ cấu hình tương đương; so sánh Depth và đường liên kết trước/sau. Đồng thời, hãy theo dõi thêm tình trạng lập chỉ mục của URL ưu tiên.
6 cách tối ưu Crawl Depth cho các trang quan trọng
Sáu giải pháp cần xem xét:
- Đơn giản hóa kiến trúc.
- Xây dựng hub và cụm chủ đề.
- Thêm liên kết theo ngữ cảnh.
- Điều chỉnh menu và breadcrumb.
- Xử lý trang mồ côi, liên kết lỗi.
- Kiểm tra phân trang, bộ lọc và JavaScript.
Đơn giản hóa kiến trúc
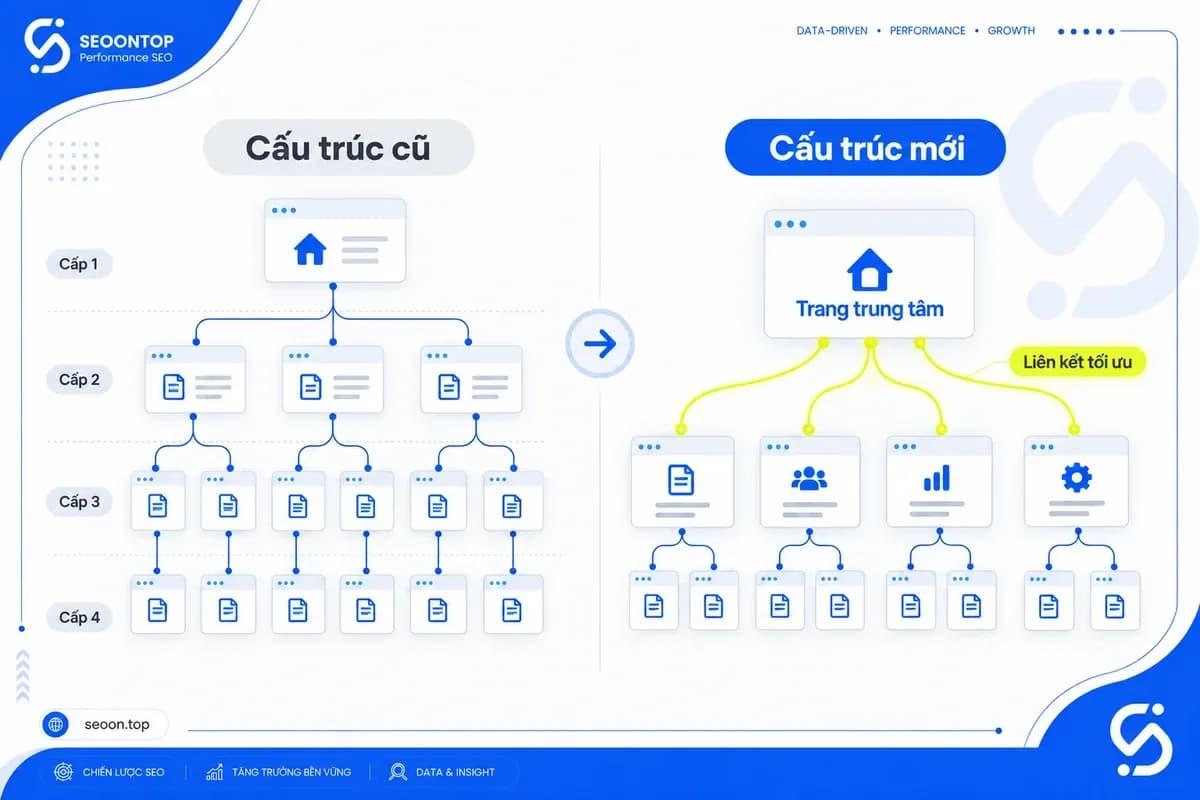
Bạn nên loại bỏ các tầng điều hướng trung gian không mang lại giá trị và ưu tiên cấu trúc phân cấp tinh gọn:
Trang chủ → Trang tổng hợp → Trang chi tiết (nếu phù hợp với nội dung).
Lưu ý: Không bắt buộc phải thay đổi URL. Việc rút ngắn đường dẫn thư mục không giúp giảm Crawl Depth, ngược lại còn dễ phát sinh rủi ro khi chuyển hướng (redirect) hoặc di chuyển website.
Xây dựng hub và cụm chủ đề
Hãy tạo trang Hub để tập hợp toàn bộ liên kết dẫn đến các bài viết thuộc cùng cụm chủ đề (topic cluster). Đồng thời, bạn cần đảm bảo trang Hub ở vị trí dễ tiếp cận và luôn được cập nhật liên kết ngay khi có bài viết mới.
Ví dụ minh họa:
Trước: Trang chủ → Giải pháp → Ngành → Sản xuất → Tài liệu
                                                        Depth 4

Sau:   Trang chủ → Giải pháp → Tài liệu
                                Depth 2
Thêm liên kết theo ngữ cảnh
Bạn hãy đặt liên kết nội bộ (internal link) ở những trang liên quan và có độ sâu nông. Sử dụng anchor text mô tả chính xác nội dung trang đích. Lưu ý rằng việc chèn liên kết từ một trang cũng nằm sâu tuy mang lại giá trị về ngữ cảnh nhưng không giúp rút ngắn đường đi của crawler.
Điều chỉnh menu và breadcrumb
- Menu: Ưu tiên hiển thị các nhóm giải pháp chủ lực.
- Breadcrumb: Giúp người dùng định vị vị trí trên website bằng cách liên kết về các cấp cha.
Lưu ý: Breadcrumb không giúp rút ngắn Crawl Depth từ trang chủ đến trang chi tiết, và dữ liệu cấu trúc BreadcrumbList cũng không thể thay thế cho liên kết thật.
Xử lý trang mồ côi và liên kết lỗi
Thêm liên kết đến trang quan trọng đang mồ côi, sửa liên kết gãy; cập nhật liên kết đi qua redirect chain (chuỗi chuyển hướng) sang URL đích phù hợp.
Lưu ý: Việc này giúp cải thiện khả năng tiếp cận chứ không nhất thiết làm giảm Crawl Depth. Không cần khôi phục các URL đã không còn giá trị.
Kiểm tra phân trang, bộ lọc và JavaScript
Theo hướng dẫn từ Google Search Central (Link best practices & JavaScript SEO basics), các liên kết phải đảm bảo crawler thu thập được (thường qua thẻ <a href> hợp lệ).
Bạn nên tránh phụ thuộc hoàn toàn vào nút "Xem thêm" hoặc thao tác cuộn trang (infinite scroll). Đội ngũ phát triển cần kiểm tra kỹ phần phân trang và chặn việc phát sinh vô hạn URL từ bộ lọc.
XML Sitemap đúng vai trò: Theo Google Search Central - Sitemaps, sitemap hỗ trợ phát hiện URL, không giảm khoảng cách liên kết. Ưu tiên URL chuẩn, có thể lập chỉ mục; không dùng sitemap thay liên kết vào trang quan trọng.
Checklist kiểm tra và tối ưu Crawl Depth
Kiến trúc
- Có danh sách URL ưu tiên theo vai trò kinh doanh.
- Đã kiểm tra trang trung tâm và các tầng điều hướng dư thừa.
Liên kết nội bộ
- Có liên kết vào những trang quan trọng, với văn bản mô tả phù hợp.
- Đã xử lý liên kết gãy và chuyển hướng không cần thiết trong phạm vi ưu tiên.
Kỹ thuật
- Đã xác minh liên kết có thể được crawler theo dõi.
- Đã kiểm tra phân trang, JavaScript và URL bộ lọc phát sinh.
Đo lường
- Có kết quả ban đầu và lần crawl lại với cấu hình tương đương.
- Đã theo dõi thêm lập chỉ mục, hiệu suất; không đánh giá thành công chỉ bằng Depth giảm.
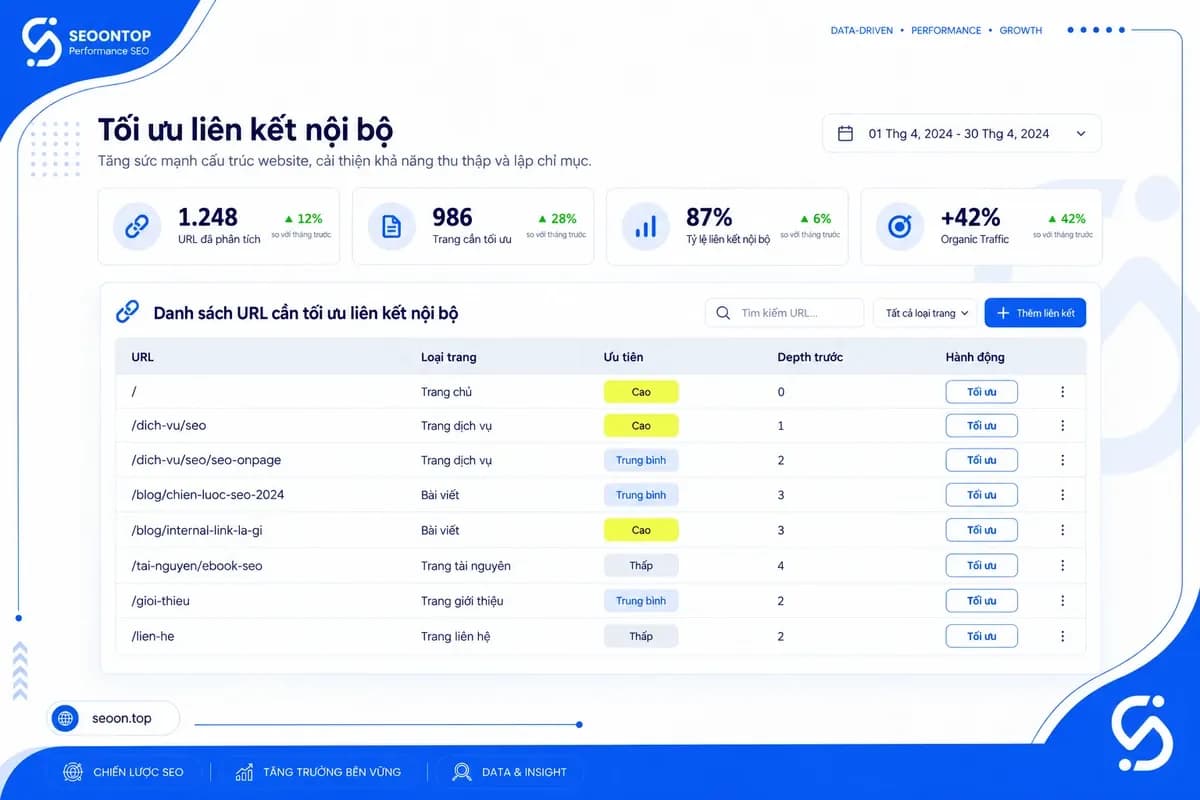
Dùng mẫu sau để giao việc; số liệu là ví dụ minh họa:
URL | Loại trang | Ưu tiên | Depth trước | Trang nguồn | Hành động | Phụ trách | Depth sau | Ngày xác minh |
|---|---|---|---|---|---|---|---|---|
| Tài liệu | Cao | 4 | Giải pháp | Thêm liên kết | Content | Chưa đo | Chưa xác minh |
Câu hỏi thường gặp
Crawl Depth là gì và tại sao chỉ số này quan trọng trong SEO?
Crawl Depth (độ sâu thu thập) là số lần nhấp chuột tối thiểu cần thiết để bot tìm kiếm tiếp cận một trang từ điểm xuất phát (thường là trang chủ). Chỉ số này quan trọng vì nó quyết định khả năng Googlebot phát hiện và lập chỉ mục nội dung, đồng thời ảnh hưởng đến sự phân bổ PageRank nội bộ trên website.
Crawl Depth khác gì với URL Depth?
Crawl Depth dựa trên khoảng cách liên kết thực tế (số lần nhấp) giữa các trang, trong khi URL Depth chỉ dựa vào số lượng dấu gạch chéo trong cấu trúc đường dẫn. Một trang có URL rất dài vẫn có thể có Crawl Depth là 1 nếu được liên kết trực tiếp từ trang chủ.
Có phải Crawl Depth càng thấp thì thứ hạng càng cao?
Không hẳn. Crawl Depth thấp giúp tăng khả năng tiếp cận và phân bổ PageRank cho trang, nhưng thứ hạng phụ thuộc vào nhiều yếu tố như chất lượng nội dung, độ uy tín và mục đích tìm kiếm. Giảm độ sâu chỉ là phương pháp tối ưu cấu trúc để hỗ trợ công cụ tìm kiếm ưu tiên thu thập các URL giá trị.
Làm thế nào để kiểm tra Crawl Depth của toàn bộ website?
Bạn có thể sử dụng các công cụ audit chuyên dụng như Screaming Frog SEO Spider hoặc Sitebulb. Sau khi cấu hình phạm vi thu thập, báo cáo "Crawl Depth Distribution" sẽ cho thấy phân phối các trang theo từng tầng độ sâu, từ đó giúp bạn nhận diện các URL quan trọng đang nằm ở vị trí quá xa.
Quy tắc "3 click" trong Crawl Depth có còn hiệu lực không?
Quy tắc "3 click" là một tiêu chuẩn tham khảo hữu ích để cải thiện trải nghiệm người dùng và điều hướng bot, không phải yêu cầu bắt buộc từ Google. Bạn nên ưu tiên duy trì các trang tạo chuyển đổi (money pages) ở độ sâu nông và chấp nhận độ sâu lớn hơn với nội dung lưu trữ.
Tại sao trang của tôi có Crawl Depth vô hạn hoặc không xác định?
Khi crawler không thể tìm thấy bất kỳ đường liên kết nào trỏ đến một trang, trang đó được coi là "orphan page" (trang mồ côi). Điều này xảy ra do lỗi kiến trúc, thiếu liên kết nội bộ hoặc do các liên kết được nhúng trong JavaScript mà bot không thể render hoặc theo dõi được.
Làm sao để tối ưu Crawl Depth cho các trang quan trọng?
Để tối ưu, hãy tinh gọn kiến trúc website, sử dụng mô hình cụm chủ đề (topic clusters) với các liên kết ngữ cảnh, tối ưu hóa điều hướng thông qua menu và breadcrumb. Đặc biệt, hãy đảm bảo các trang ưu tiên có đường dẫn trực tiếp từ trang chủ hoặc các trang hub uy tín.
Xem thêm:
- Web Crawler là gì? Cách bot thu thập dữ liệu website cho SEO
- Googlebot là gì? Cách tối ưu website để Google thu thập dữ liệu
- SEO audit là gì? Quy trình kiểm tra SEO website hiệu quá
Kết luận
Hiểu đúng về Crawl Depth sẽ giúp bạn đọc cấu trúc website qua khoảng cách liên kết, thay vì độ dài URL. Giá trị của chỉ số này nằm ở việc phát hiện trang quan trọng khó tiếp cận, không phải đưa mọi trang về cùng một mức sâu.
Bước tiếp theo là chọn URL ưu tiên, xác minh đường đi ngắn nhất và bổ sung liên kết phù hợp. Sau đó, crawl lại để kiểm tra thay đổi kiến trúc; đối chiếu riêng tình trạng lập chỉ mục và hiệu suất SEO.