Regex trong Google Search Console: Cách lọc truy vấn và URL bằng ví dụ thực hành
Regex trong Google Search Console là gì?
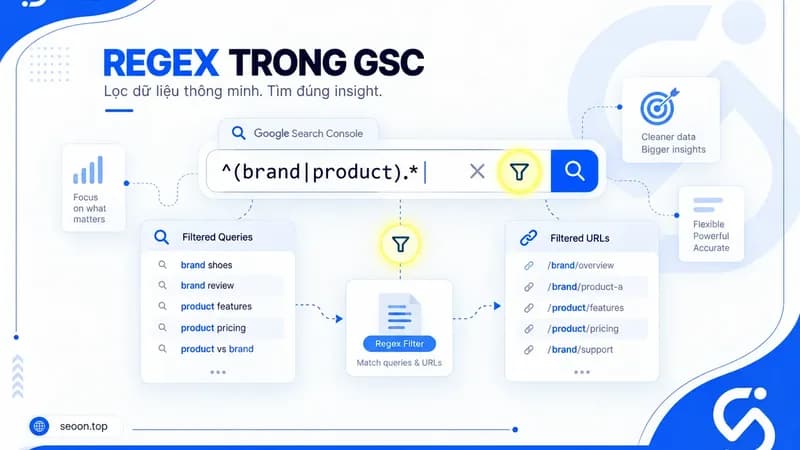
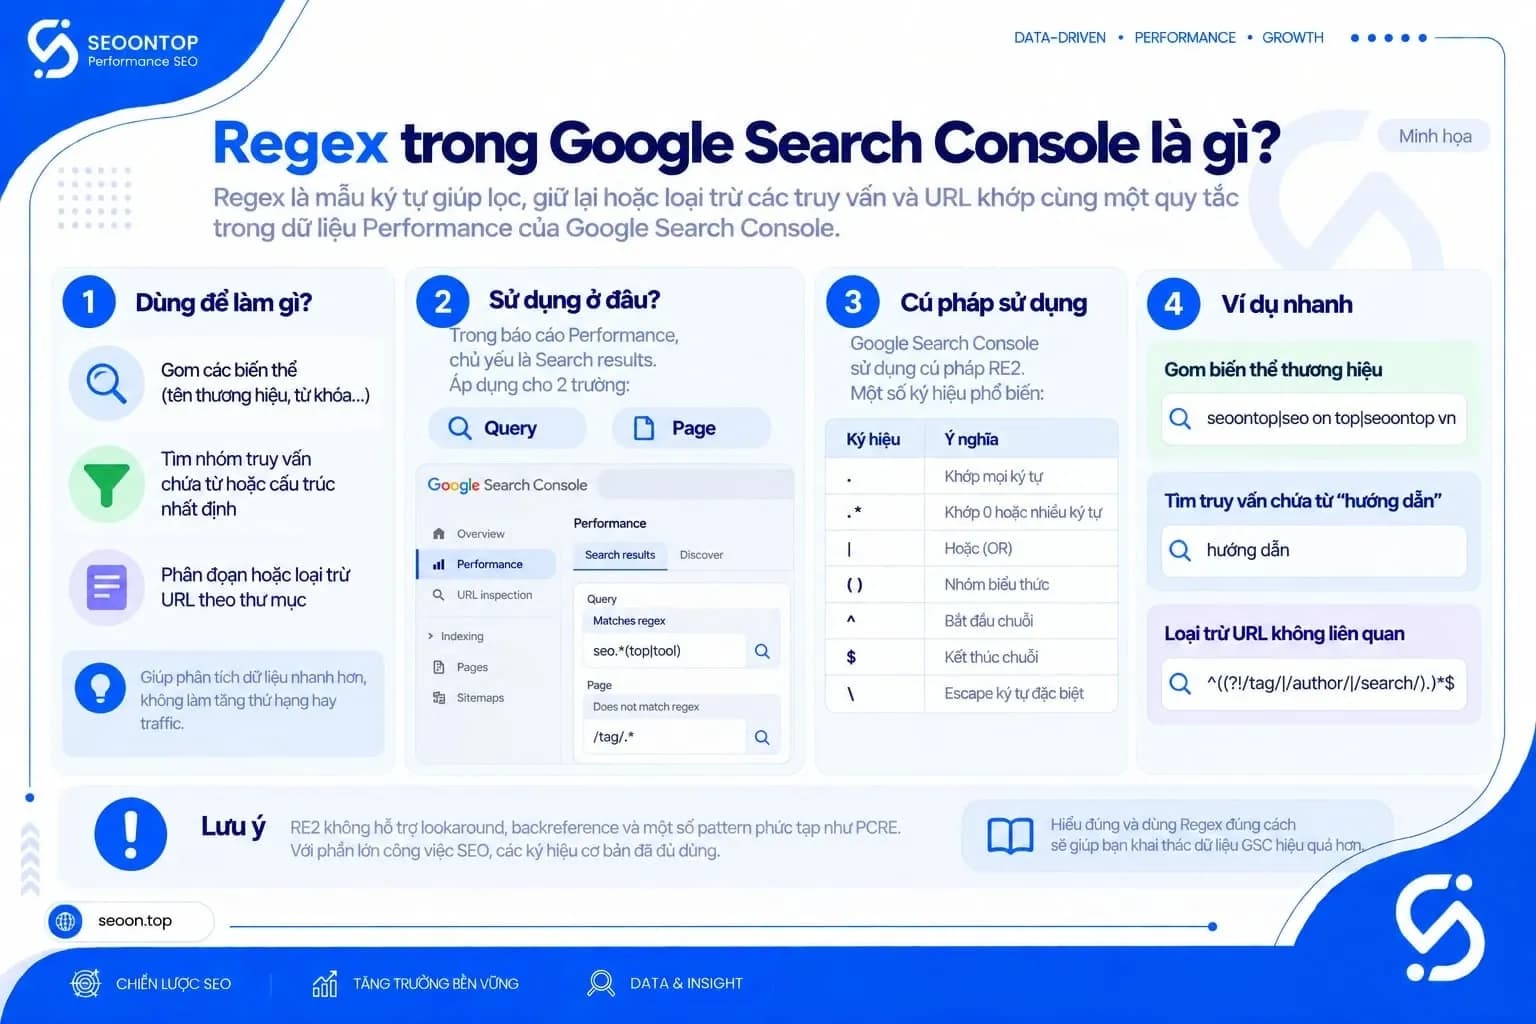
Regex trong Google Search Console là mẫu ký tự dùng để giữ lại hoặc loại trừ những truy vấn và URL khớp cùng một quy tắc. Bạn có thể dùng Regex để gom các biến thể tên thương hiệu, tìm nhóm truy vấn chứa từ hoặc cấu trúc nhất định, phân đoạn website theo thư mục và loại những URL không thuộc câu hỏi đang phân tích.
Regex chỉ phân đoạn phần dữ liệu mà Google Search Console ghi nhận và hiển thị. Nó không trực tiếp làm tăng thứ hạng, tạo traffic hay tự xác định chính xác ý định tìm kiếm. Bài viết tập trung vào báo cáo Performance, chủ yếu là Search results, với hai trường Query và Page.
Search Console sử dụng cú pháp RE2, vì vậy một biểu thức hoạt động trong PCRE, JavaScript hoặc công cụ kiểm thử khác chưa chắc hoạt động tương tự trong GSC. RE2 không hỗ trợ một số cấu trúc như lookaround và backreference; với phần lớn công việc SEO, các ký hiệu cơ bản như |, (), ^, $, .* và escape bằng \ đã đủ dùng.
Bạn có thể đối chiếu phạm vi hỗ trợ tại hướng dẫn Regex của Google Search Central và tài liệu cú pháp RE2.
Cách tạo và kiểm tra một bộ lọc Regex trong GSC
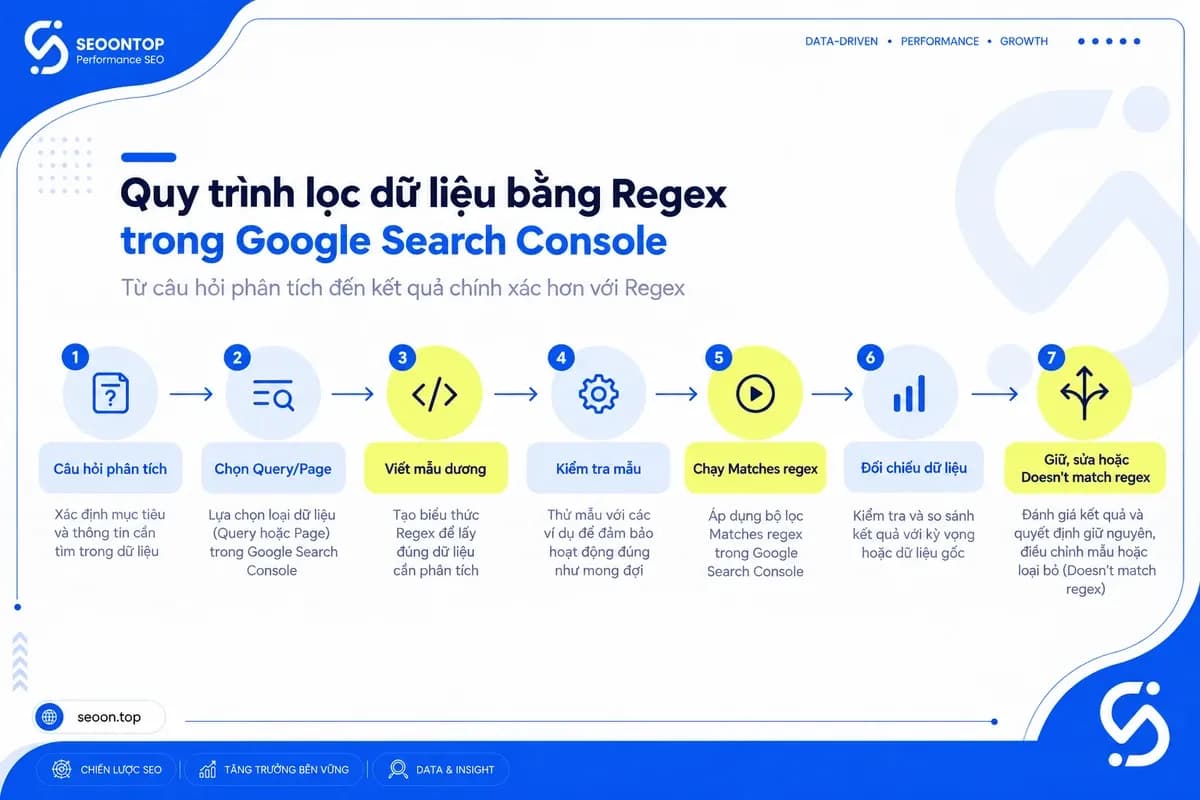
Bắt đầu từ câu hỏi phân tích, không bắt đầu từ công thức Regex
Trước khi viết biểu thức, hãy xác định chính xác bạn muốn kiểm tra điều gì. Câu hỏi phân tích quyết định trường dữ liệu, chế độ khớp và cấu trúc Regex cần dùng. Trong giao diện hiện hành, quy trình thường là:
- Mở Performance → Search results.
- Chọn + New hoặc thêm bộ lọc mới.
- Chọn Query hoặc Page.
- Chọn Custom (regex).
- Chọn Matches regex hoặc Doesn’t match regex.
- Nhập biểu thức và kiểm tra các hàng kết quả.
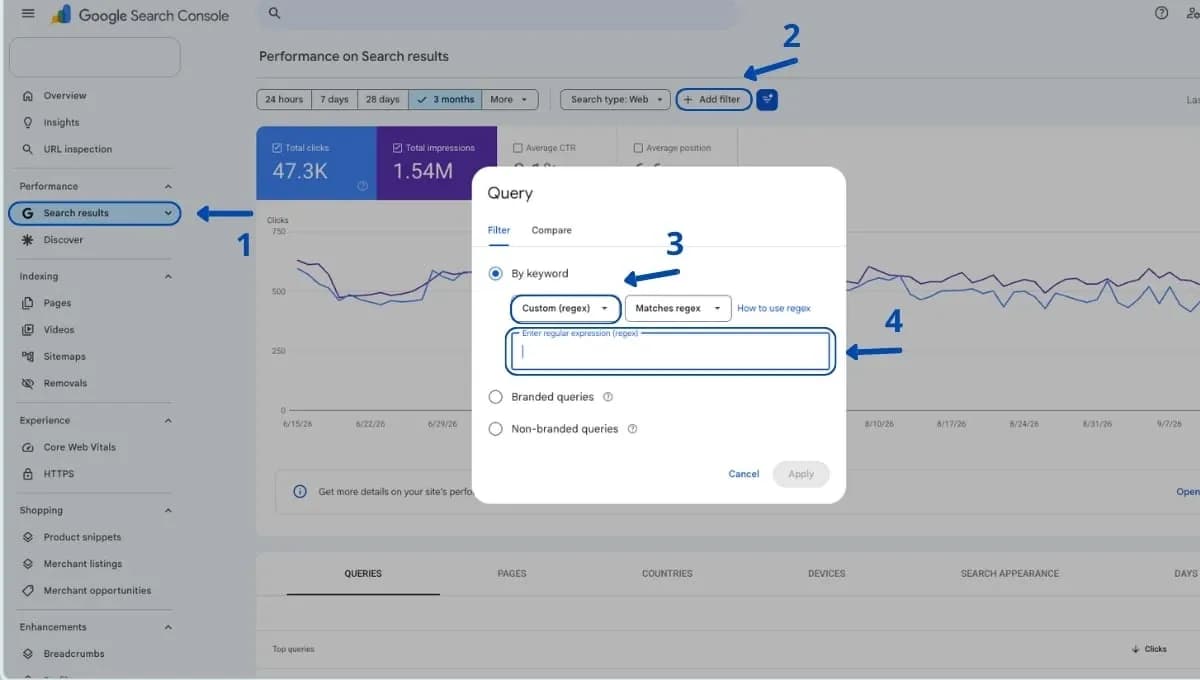
Tên hoặc vị trí nút có thể thay đổi đôi chút theo ngôn ngữ và cập nhật giao diện. Tài liệu chính thức về bộ lọc và báo cáo Performance được duy trì tại Google Search Console Help.
Câu hỏi đang kiểm tra | Trường cần chọn |
|---|---|
Truy vấn nào có nhắc đến “SEO On Top”? | Query |
Truy vấn nào chứa “giá” hoặc “đặt lịch”? | Query |
Những URL nào thuộc thư mục | Page |
Những URL nào chứa tham số | Page |
Không nên đặt mẫu URL vào Query, hoặc đặt danh sách từ khóa vào Page, rồi diễn giải chúng như cùng một loại dữ liệu. Query kiểm tra chuỗi truy vấn người dùng nhập trên Google; Page kiểm tra URL nhận impression hoặc click.
Hai chế độ Regex có chức năng khác nhau:
- Matches regex: Giữ lại các hàng khớp biểu thức.
- Doesn’t match regex: Giữ lại các hàng không khớp biểu thức.
Muốn tạo bộ lọc âm, hãy viết mẫu dương trước rồi chọn Doesn’t match regex. Không thêm dấu trừ trước biểu thức, bởi dấu trừ không phải cú pháp tạo bộ lọc âm trong GSC.
Với website của bạn, câu hỏi đầu tiên có thể là: Những truy vấn nào có nhắc đến tên thương hiệu hoặc các biến thể của nó?
Các thành phần RE2 đủ dùng cho công việc SEO
Thành phần | Ý nghĩa | Khi nên dùng |
|---|---|---|
Ký tự thông thường | Khớp chuỗi ký tự được nhập. | Tên thương hiệu, cụm từ, thư mục URL. |
` | ` | OR, khớp một trong nhiều phương án. |
| Nhóm các phương án hoặc thành phần. | Làm rõ cấu trúc biểu thức. |
| Neo vào đầu chuỗi. | Chỉ giữ truy vấn hoặc URL bắt đầu theo cấu trúc xác định. |
| Neo vào cuối chuỗi. | Kiểm tra phần kết thúc của truy vấn hoặc URL. |
| Khớp một chuỗi ký tự bất kỳ, kể cả chuỗi rỗng. | Nối hai phần cố định có đoạn biến đổi ở giữa. |
| Escape ký tự có ý nghĩa đặc biệt. | Khớp dấu |
Toán tử OR là |. Chẳng hạn, biểu thức sau khớp một trong ba biến thể tên thương hiệu:
seo on top|sot
Bạn không viết \| trong trường hợp này, dạng \| chỉ dùng khi bạn thực sự muốn khớp ký tự gạch đứng theo nghĩa đen.
GSC có thể khớp biểu thức ở một phần của chuỗi nếu bạn không dùng neo:
giácó thể khớp truy vấn chứa “giá” ở nhiều vị trí.^giáyêu cầu chuỗi bắt đầu bằng “giá”.giá$yêu cầu chuỗi kết thúc bằng “giá”.^giá$yêu cầu toàn bộ chuỗi đúng bằng “giá”.
Vì cơ chế khớp một phần, bạn không cần thêm .* trước và sau mọi từ khóa. Nếu mục tiêu chỉ là tìm truy vấn có chứa “giá”, biểu thức giá thường đã đủ; .*giá.* không tạo thêm giá trị đáng kể cho câu hỏi đó.
.* hữu ích khi có hai phần cố định và một đoạn biến đổi ở giữa. Ví dụ, shoes/.*/green mô tả URL có phần shoes/, sau đó là một đoạn có thể thay đổi, rồi đến /green.
Regex trong GSC mặc định không phân biệt chữ hoa và chữ thường. Khi thực sự cần bật phân biệt hoa - thường, RE2 có modifier (?-i), nhưng chỉ nên dùng sau khi đã kiểm tra dữ liệu thực tế và xác định việc phân biệt này cần thiết.
Không dùng lookahead, lookbehind hoặc backreference trong biểu thức GSC. Nếu muốn loại tên thương hiệu, cách dễ kiểm tra hơn là viết mẫu brand dương, xem tập kết quả bằng Matches regex, sau đó đổi sang Doesn’t match regex.
Kiểm tra cú pháp, logic và dữ liệu thực tế
Một biểu thức chạy được chưa chắc trả lời đúng câu hỏi. Bạn hãy kiểm tra theo ba tầng:
- Kiểm tra cú pháp và khả năng tương thích: Biểu thức có tuân theo RE2 và tránh các cấu trúc không được hỗ trợ hay không.
- Kiểm tra logic bằng chuỗi mẫu: Lập danh sách chuỗi phải khớp, không được khớp và dễ bị khớp nhầm.
- Kiểm tra trong GSC: Xem các truy vấn hoặc URL thực tế được giữ lại có đúng với mục tiêu phân tích không.
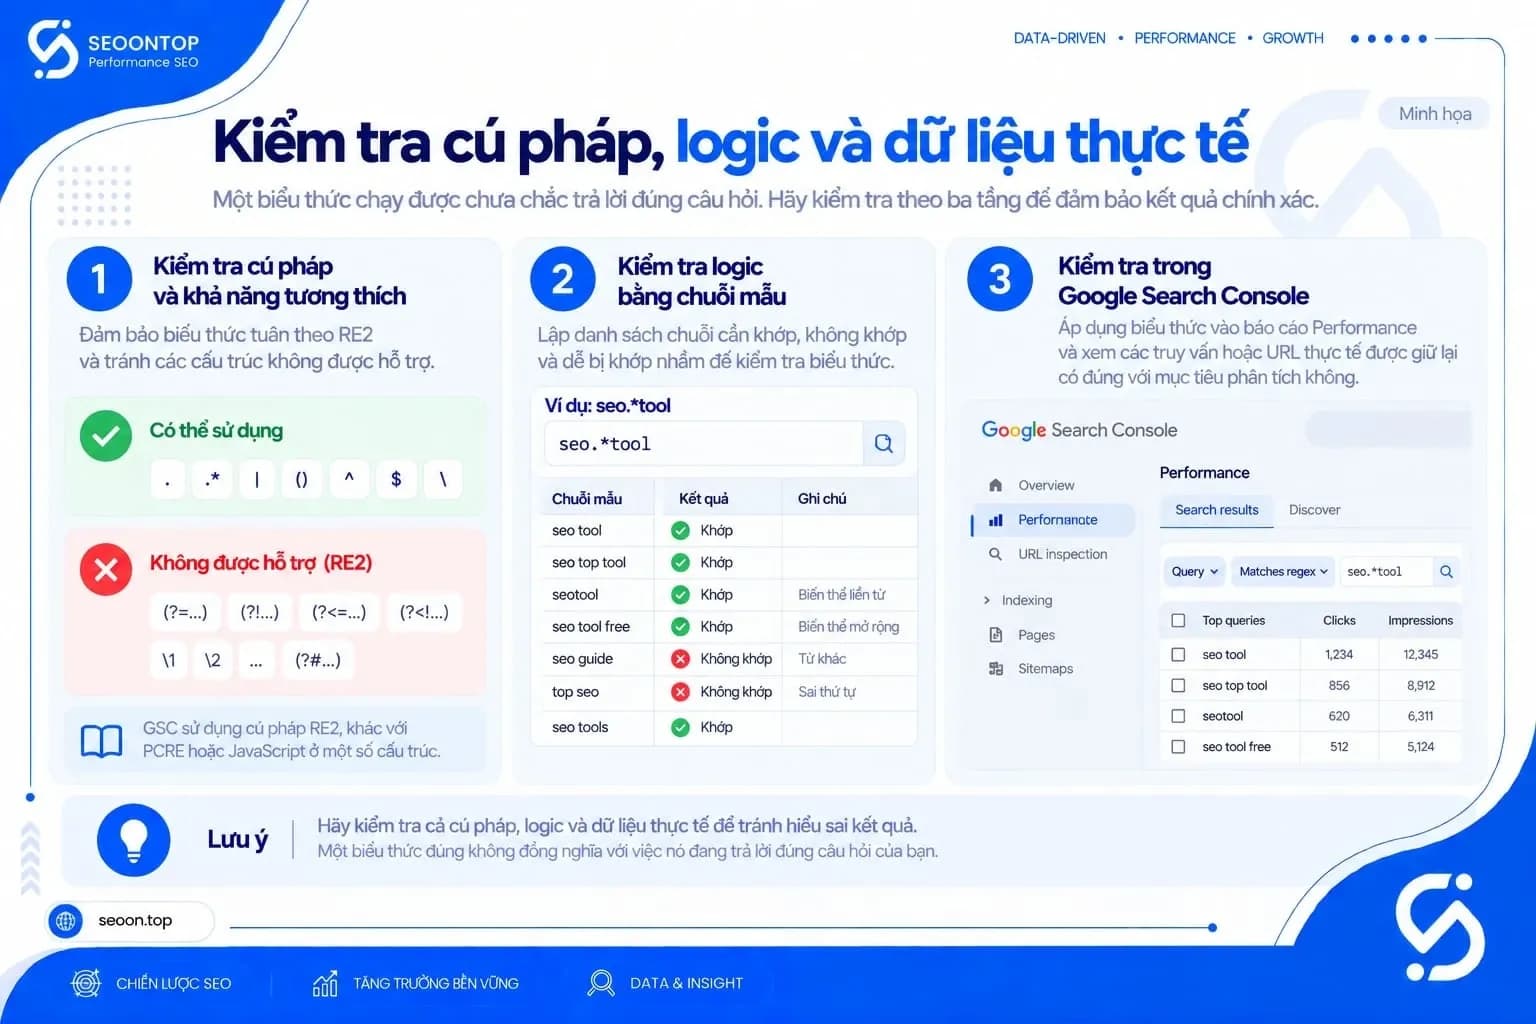
Với mẫu seo on top|sot|seoontop có thể chuẩn bị tập kiểm tra như sau:
- Phải khớp:
seo on top,công ty seo on top,sot. - Không được khớp:
cty seo on top. - Cần xem kỹ: Lỗi chính tả, tên viết tắt hoặc một biến thể quá ngắn có thể xuất hiện bên trong từ không liên quan.
Mẫu chạy được chưa chắc mẫu trả lời đúng câu hỏi.
Có hai loại lỗi cần phân biệt:
- Lỗi cú pháp hoặc tương thích: Biểu thức chứa cấu trúc RE2 không hỗ trợ hoặc không thể được xử lý như dự kiến.
- Lỗi logic: Biểu thức vẫn chạy nhưng giữ sai dữ liệu, chẳng hạn một từ quá ngắn khớp bên trong nhiều chuỗi khác hoặc neo được đặt sai vị trí.
Nếu bộ lọc không trả về dữ liệu, đừng kết luận ngay rằng website không có nhóm truy vấn hoặc URL đó. Hãy kiểm tra lần lượt:
- Phạm vi ngày có phù hợp không.
- Đã chọn đúng Query hay Page chưa.
- Đang dùng Matches regex hay Doesn’t match regex.
- Biểu thức có chứa cấu trúc không tương thích với RE2 không.
- Các chuỗi thực tế có đúng cách viết mà biểu thức đang yêu cầu không.
- Những bộ lọc khác về quốc gia, thiết bị hoặc loại tìm kiếm có đang thu hẹp dữ liệu không.
Nếu kiểm thử ở công cụ bên ngoài, hãy chọn engine hoặc chế độ tương thích RE2 rồi vẫn đối chiếu lại trong GSC. Một công cụ dùng regex flavor khác có thể chấp nhận cú pháp mà Search Console không hỗ trợ. Bộ lọc loại trừ cần được kiểm tra cẩn thận hơn vì lỗi khớp rộng có thể âm thầm loại bỏ dữ liệu hữu ích:
- Viết mẫu dương từ các truy vấn hoặc URL thực tế.
- Chạy mẫu bằng Matches regex để xem toàn bộ nhóm sắp bị loại.
- Sửa biểu thức nếu có hàng hữu ích bị khớp nhầm.
- Chỉ sau đó chuyển sang Doesn’t match regex.
Các dấu hiệu cho thấy biểu thức quá rộng gồm:
- Nhiều hàng không liên quan cùng xuất hiện.
- Một từ ngắn khớp bên trong nhiều chuỗi khác.
- Khi chuyển sang bộ lọc âm, dữ liệu giảm mạnh nhưng bạn không xác định được nhóm nào đã bị loại.
- Biểu thức chứa nhiều lựa chọn nhưng chưa từng được kiểm tra riêng từng phần.
Cách sửa có thể là thêm chuỗi cụ thể, nhóm các phương án bằng ngoặc, escape ký tự đặc biệt, thêm neo khi vị trí là điều kiện bắt buộc hoặc tách một biểu thức phức tạp thành nhiều mẫu nhỏ để kiểm tra.
Phân nhóm truy vấn bằng Regex
Tách branded và non-branded bằng cùng một mẫu
Để phân đoạn truy vấn theo thương hiệu, hãy bắt đầu từ các biến thể thực sự xuất hiện trong dữ liệu, có thể gồm:
- Tên thương hiệu đầy đủ.
- Cách viết liền hoặc viết cách.
- Phiên bản có dấu và không dấu.
- Tên viết tắt.
- Lỗi chính tả phổ biến đã quan sát được.
- Tên sản phẩm độc quyền, nếu mục tiêu phân tích coi đó là truy vấn liên quan đến thương hiệu.
Với SEO On Top, mẫu ban đầu là: seo on top|sot|seoontop
Chạy mẫu này trên Query bằng Matches regex để xem các truy vấn chứa những biến thể đã khai báo. Sau khi kiểm tra tập kết quả, giữ nguyên biểu thức và chuyển sang Doesn’t match regex để xem phần truy vấn không khớp mẫu.
Cách đặt tên hai phân đoạn nên phản ánh đúng điều Regex xác nhận:
- Matches regex: Truy vấn khớp các biến thể SEO On Top đã khai báo.
- Doesn’t match regex: Truy vấn không khớp các biến thể đó.
Không nên gọi nhóm thứ hai là “người chưa biết thương hiệu”, “khách hàng mới” hoặc “toàn bộ non-brand traffic” theo nghĩa tuyệt đối. Một người đã biết thương hiệu vẫn có thể tìm bằng truy vấn không chứa tên brand; ngược lại, danh sách Regex có thể bỏ sót tên viết tắt, lỗi chính tả hoặc tên sản phẩm gắn với thương hiệu.
Khi so sánh hai phân đoạn, hãy giữ nguyên property, loại tìm kiếm, phạm vi ngày, quốc gia, thiết bị và các bộ lọc liên quan. Nếu đồng thời thay đổi Regex và phạm vi dữ liệu, chênh lệch quan sát được không còn chỉ phản ánh hai nhóm truy vấn.
Tìm truy vấn dạng câu hỏi
Có hai mục tiêu lọc khác nhau:
- Tìm từ nghi vấn xuất hiện ở bất kỳ vị trí nào.
- Chỉ tìm truy vấn bắt đầu bằng từ nghi vấn.
Biểu thức sau tìm các cụm được chọn ở bất kỳ vị trí nào mà cơ chế khớp cho phép:
ai|gì|ở đâu|khi nào|tại sao|như thế nào
Nếu chỉ muốn giữ truy vấn bắt đầu bằng một trong các cụm đó, thêm neo đầu chuỗi:
^(ai|gì|ở đâu|khi nào|tại sao|như thế nào)
Mẫu có neo phù hợp hơn khi câu hỏi phân tích là “truy vấn nào bắt đầu bằng từ nghi vấn?”. Mẫu không neo có phạm vi rộng hơn, hữu ích khi cụm nghi vấn có thể xuất hiện ở giữa truy vấn.
Danh sách từ cần phù hợp với ngôn ngữ và dữ liệu thực tế của website. Không nên sao chép nguyên danh sách tiếng Anh như who|what|where|when|why|how nếu phần lớn truy vấn là tiếng Việt.
Ngoài ra, từ ngắn có thể xuất hiện bên trong một chuỗi khác. Vì vậy, hãy đọc truy vấn đầy đủ trong bảng kết quả thay vì mặc định mọi hàng khớp đều là câu hỏi hoàn chỉnh.
Tập kết quả chỉ là danh sách ứng viên cho việc phân tích nhu cầu nội dung. Regex xác nhận sự xuất hiện hoặc vị trí của một cụm từ; nó không xác nhận người tìm đang ở một giai đoạn cụ thể trong hành trình mua hay website nhất thiết phải tạo bài viết mới cho mọi truy vấn được tìm thấy.
Lọc truy vấn có tín hiệu thương mại hoặc so sánh
Để tìm các truy vấn chứa một số tín hiệu thương mại đã chọn, có thể dùng:
mua|giá|đặt hàng
Tên gọi phù hợp của tập này là truy vấn chứa tín hiệu thương mại đã chọn, không phải toàn bộ truy vấn giao dịch. Một truy vấn chứa “giá” có thể liên quan đến cân nhắc mua, nhưng cũng có thể mang mục đích nghiên cứu, so sánh hoặc tìm thông tin chung.
Cách đọc kết quả nên tách thành ba tầng:
Quan sát: Truy vấn chứa từ “giá”.
Suy luận có điều kiện: Người tìm có thể đang quan tâm đến chi phí hoặc cân nhắc mua.
Việc cần kiểm tra: Đọc toàn bộ truy vấn, xem trang đích và hiệu suất của nhóm trước khi quyết định tạo hoặc sửa nội dung.
Ví dụ, sau khi chạy lệnh mua|giá|đặt hàng trên Query, hãy chọn một số truy vấn đầy đủ và kiểm tra:
- Trang nào đang nhận impression hoặc click cho truy vấn đó.
- Nội dung trang có trả lời đúng nhu cầu thể hiện trong truy vấn không.
- Truy vấn có thực sự liên quan đến sản phẩm của website không.
- Một từ được chọn có đang khớp trong ngữ cảnh ngoài dự kiến không.
Nhóm truy vấn so sánh cũng có thể được tạo bằng một biểu thức như:
so sánh|khác nhau|hay
Trong đó, “hay” cần được kiểm tra đặc biệt vì có thể mang nhiều nghĩa. Regex chỉ phát hiện chuỗi ký tự; bạn vẫn cần đọc ngữ cảnh trước khi xếp truy vấn vào một nhóm ý định.
Phân đoạn website bằng Regex cho Page
Lọc thư mục bằng phần đường dẫn ổn định
Muốn phân đoạn các khu vực website, hãy chọn Page và dùng phần đường dẫn ổn định trong URL. Nếu cấu trúc website nhất quán, /blog/ có thể dùng để tìm URL chứa thư mục blog, còn /san-pham/ có thể dùng để tìm URL chứa thư mục sản phẩm.
Mục tiêu | Mẫu | URL nên khớp | URL không nên khớp |
|---|---|---|---|
Tìm URL chứa thư mục blog |
| URL có | URL không chứa |
Tìm URL chứa thư mục sản phẩm |
| URL có | URL không chứa |
Đây là phép khớp chuỗi URL. GSC không tự hiểu /blog/ là bài viết hay /san-pham/ là trang thương mại. Ý nghĩa đó chỉ đúng nếu cấu trúc website thực tế được tổ chức như vậy.
Do GSC có thể khớp một phần chuỗi, bạn thường không cần viết .*\/blog\/.* nếu mục tiêu chỉ là tìm mọi URL chứa /blog/. Mẫu /blog/ đơn giản hơn và dễ kiểm tra hơn.
Sau khi tạo hai bộ lọc Page riêng cho /blog/ và /san-pham/, bạn có thể xem truy vấn và hiệu suất của từng khu vực. Tuy nhiên, chưa thể kết luận khu vực nào “tốt hơn” chỉ từ việc phân đoạn; cần đọc các chỉ số trong cùng điều kiện và theo mục tiêu riêng của từng loại trang.
Dùng neo khi vị trí trong URL là một phần của quy tắc
Mẫu không neo có thể khớp chuỗi ở nhiều vị trí. Neo chỉ nên được thêm khi vị trí là một phần bắt buộc của quy tắc.
^yêu cầu phần sau nó xuất hiện ở đầu chuỗi.$yêu cầu phần trước nó xuất hiện ở cuối chuỗi.
Với Page, hãy quan sát URL đầy đủ trong GSC trước khi viết biểu thức neo đầu. Bạn cần biết property đang hiển thị giao thức, hostname và cấu trúc URL như thế nào.
Ví dụ minh họa với placeholder:
^https://www.example.com/san-pham/
Mẫu này chỉ phù hợp nếu URL thực tế bắt đầu đúng bằng chuỗi đó. Nếu property có cả hostname có và không có www, nhiều subdomain hoặc biến thể giao thức, biểu thức có thể quá hẹp và bỏ sót URL.
Trong khi đó, mẫu không neo:
/san-pham/
sẽ tìm chuỗi thư mục ở bất kỳ vị trí phù hợp nào trong URL. Nó đơn giản hơn nhưng có thể khớp thêm URL nếu cùng chuỗi xuất hiện ở nơi ngoài dự kiến.
Neo cuối $ phù hợp khi phần kết thúc URL là điều kiện phân đoạn, chẳng hạn một đuôi file hoặc đoạn kết thúc ổn định. Không nên thêm neo chỉ vì biểu thức trông “chặt” hơn; neo làm giảm khớp thừa nhưng cũng có thể loại bỏ các biến thể URL hợp lệ.
Dùng .* và escape ký tự đặc biệt đúng lúc
.* dùng để nối hai thành phần cố định khi phần nằm giữa có thể thay đổi. Ví dụ:
shoes/.*/green
Biểu thức này phù hợp với một cấu trúc có shoes/, tiếp theo là một đoạn biến đổi, rồi đến /green.
Trong ví dụ này, mẫu:
/san-pham/.*/tra-xanh
chỉ hợp lý nếu URL thực sự có một đoạn biến đổi nằm giữa /san-pham/ và /tra-xanh. Nếu đường dẫn chỉ là /san-pham/tra-xanh, việc thêm .* không cần thiết và có thể khiến quy tắc khó đọc hơn.
Một số ký tự có ý nghĩa đặc biệt trong Regex nên phải được escape khi cần khớp theo nghĩa đen. Dấu hỏi là một trường hợp như vậy:
\?s=
Mẫu này có thể dùng để tìm URL chứa tham số ?s=, nhưng chỉ khi website thực sự sử dụng tham số đó và URL tương ứng xuất hiện trong dữ liệu GSC.
Quy trình loại nhóm URL này nên là:
- Chọn Page.
- Chạy
\?s=bằng Matches regex. - Kiểm tra toàn bộ URL được giữ lại.
- Xác nhận chúng không thuộc phạm vi câu hỏi phân tích.
- Chuyển sang Doesn’t match regex nếu cần loại chúng.
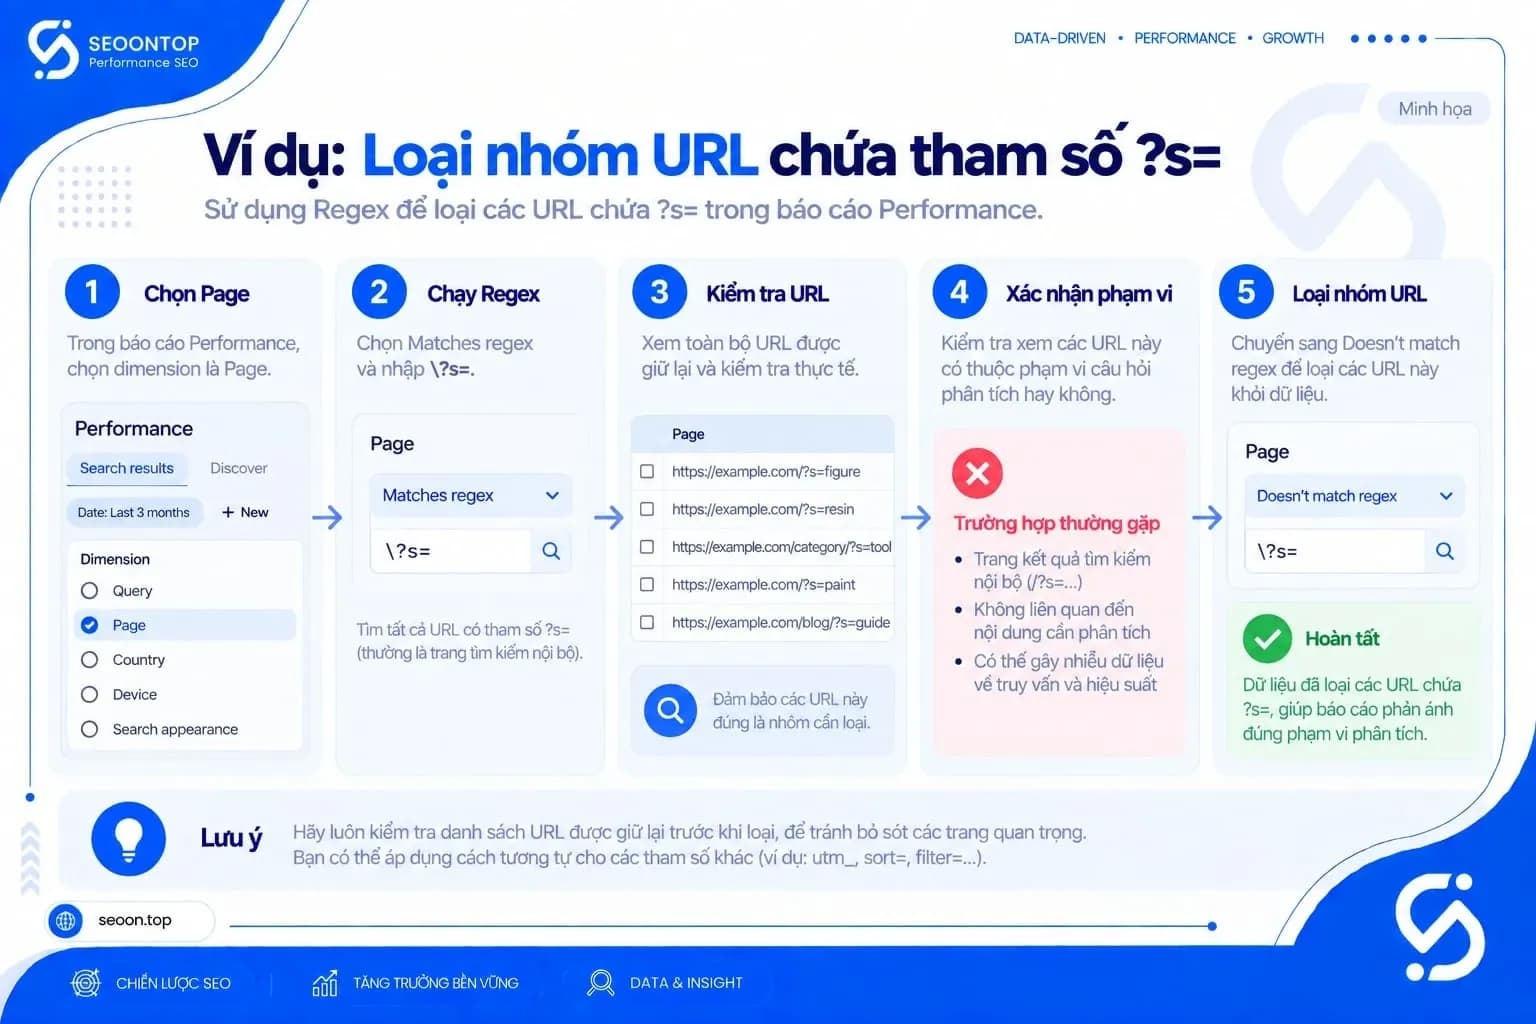
Không nên đưa /admin/, /login/, ?s= hay một danh sách mẫu có sẵn vào bộ lọc âm của mọi website. Mỗi mẫu loại trừ cần được xác nhận từ cấu trúc URL và dữ liệu thực tế.
Đọc kết quả Regex với đúng giới hạn dữ liệu
Chỉ so sánh các nhóm trong cùng điều kiện
Khi so sánh hai nhóm Query hoặc Page, hãy giữ nhất quán:
- Property.
- Loại tìm kiếm.
- Phạm vi ngày.
- Quốc gia.
- Thiết bị.
- Search appearance nếu đang áp dụng.
- Những bộ lọc khác có ảnh hưởng đến tập dữ liệu.
Ví dụ, có thể so sánh /blog/ và /san-pham/ trong cùng phạm vi ngày, cùng quốc gia và cùng loại thiết bị. Nếu nhóm /blog/ được xem trên thiết bị di động tại Việt Nam nhưng nhóm /san-pham/ được xem trên mọi thiết bị và mọi quốc gia, chênh lệch không còn phản ánh riêng hai khu vực website.
Nếu cần đổi quốc gia hoặc thiết bị, hãy coi đó là một lát cắt phân tích mới. Không quy toàn bộ khác biệt cho Regex khi nhiều điều kiện dữ liệu đã thay đổi cùng lúc.
Dữ liệu Search Console phản ánh phần hoạt động tìm kiếm được hệ thống ghi nhận và hiển thị trong phạm vi báo cáo. Nó không đại diện đầy đủ cho toàn bộ nhu cầu thị trường hoặc mọi người tìm kiếm tiềm năng.
Hiểu đúng các chỉ số trong phạm vi bộ lọc
Các chỉ số cần được đọc trong chính phạm vi ngày và bộ lọc đang áp dụng:
- Clicks: số lượt nhấp được ghi nhận trong tập dữ liệu đã lọc.
- Impressions: số lần URL hoặc truy vấn được ghi nhận hiển thị trong cùng phạm vi.
- CTR: tỷ lệ click trên impression của tập dữ liệu đang xem.
- Average position: vị trí trung bình trong tập dữ liệu đã lọc, không phải một thứ hạng cố định áp dụng cho mọi lượt tìm kiếm.
CTR thấp không tự chứng minh nội dung kém. Khi thấy một nhóm có CTR thấp, cần xem thêm:
- Vị trí trung bình của nhóm.
- Loại truy vấn đang được gom.
- Trang đích xuất hiện.
- Mức độ phù hợp giữa truy vấn và trang.
- Đặc điểm của trang kết quả tìm kiếm.
- Việc biểu thức có đang gộp nhiều ngữ cảnh khác nhau hay không.
Tương tự, một nhóm có nhiều impression hơn không tự động quan trọng hơn đối với mục tiêu nội dung hoặc kinh doanh. Nhiều impression chỉ cho biết quy mô hiển thị trong điều kiện đang xem; quyết định ưu tiên còn phụ thuộc vào mức độ liên quan, trang đích và mục tiêu của website.
Không xem các phân đoạn là phép chia tuyệt đối toàn bộ traffic
Khi dùng cùng một mẫu để xem phần khớp và không khớp, không nên mặc định hai nhóm sẽ cộng lại đúng bằng tổng số liệu chưa lọc của property. Dữ liệu truy vấn có thể chịu ảnh hưởng của truy vấn ẩn danh, giới hạn các hàng được hiển thị và phương pháp tổng hợp dữ liệu của Search Console.
Cách diễn đạt phù hợp là:
- “Phân đoạn trên phần dữ liệu truy vấn có thể lọc và hiển thị.”
- “Truy vấn khớp các biến thể thương hiệu đã khai báo.”
- “Truy vấn không khớp mẫu brand hiện tại.”
Tránh diễn đạt thành:
- “Toàn bộ organic traffic.”
- “Tất cả người đã biết thương hiệu.”
- “Tất cả khách hàng mới.”
- “Toàn bộ truy vấn giao dịch.”
Regex xác nhận được: Một chuỗi có hoặc không khớp quy tắc đã viết.Regex không xác nhận được: Ý định chắc chắn, mức độ nhận biết thương hiệu, tình trạng khách hàng mới hay cũ hoặc giá trị kinh doanh của người tìm.
Với SEO On Top, nhóm branded chỉ có nghĩa là truy vấn khớp seo on top|sot|seoontop và những biến thể khác đã được thêm vào mẫu. Phần còn lại chỉ là các truy vấn không khớp danh sách đó. Nếu danh sách brand chưa đầy đủ, nhóm không khớp vẫn có thể chứa truy vấn liên quan đến thương hiệu.
Dữ liệu sau khi lọc “sạch hơn” cũng không đương nhiên “đúng hơn”. Tiêu chuẩn quan trọng là phần dữ liệu được giữ lại có trả lời đúng câu hỏi phân tích ban đầu hay không.
Bạn hãy bắt đầu bằng một bài toán nhỏ như tách truy vấn theo brand hoặc xem riêng /blog/. Viết mẫu đơn giản nhất có thể, chuẩn bị các chuỗi phải khớp, không được khớp và dễ khớp nhầm, rồi chạy Matches regex để kiểm tra dữ liệu thực tế. Chỉ chuyển sang loại trừ hoặc sử dụng phân đoạn trong báo cáo khi các hàng được giữ lại phù hợp với quy tắc bạn đã đặt ra.
Câu hỏi thường gặp
Tại sao bộ lọc Regex của tôi không trả về dữ liệu nào?
Khi bộ lọc Regex không hiển thị kết quả, nguyên nhân thường do cú pháp không hợp lệ với engine RE2 hoặc logic bộ lọc quá hẹp. GSC không hiển thị thông báo lỗi cú pháp mà chỉ trả về không có hàng nào khớp. Bạn hãy kiểm tra lại bằng các bước:
- Xác nhận biểu thức không chứa lookaround hoặc backreference.
- Đảm bảo các ký tự đặc biệt như dấu hỏi
?đã được escape (ví dụ\?s=). - Thử nghiệm với một mẫu rất đơn giản (ví dụ chỉ một từ khóa) để xác nhận hệ thống đang phản hồi đúng.
Làm cách nào để lọc đồng thời nhiều thư mục khác nhau?
Bạn có thể sử dụng toán tử OR | để nhóm các thư mục trong cùng một bộ lọc Page. Ví dụ, để xem dữ liệu cho cả /blog/ và /san-pham/, bạn hãy nhập biểu thức blog|san-pham. GSC sẽ giữ lại mọi URL chứa một trong hai cụm từ này.
Lưu ý rằng biểu thức này sẽ khớp với bất kỳ URL nào có chứa chuỗi đó, vì vậy hãy kiểm tra danh sách kết quả thực tế để đảm bảo không có các trang ngoài ý muốn bị gom vào.
Regex có phân biệt chữ hoa và chữ thường không?
Mặc định, biểu thức chính quy trong GSC không phân biệt hoa thường, nếu bạn thực sự cần kiểm soát tính phân biệt này, bạn có thể thêm tiền tố (?-i) vào đầu biểu thức. Tuy nhiên, trong hầu hết các tác vụ SEO thông thường như lọc truy vấn hoặc URL, cài đặt mặc định là đủ dùng và giúp bạn tránh việc bỏ sót dữ liệu do sai biệt kiểu viết.
Tôi có thể dùng Regex để loại bỏ dữ liệu "nhiễu" không?
Có, bằng cách sử dụng chế độ Doesn't match regex. Bạn không cần thêm dấu trừ hoặc các tiền tố phủ định vào biểu thức. Quy trình an toàn là:
- Đầu tiên hãy nhập mẫu biểu thức đó vào chế độ Matches regex để xem toàn bộ danh sách các mục sắp bị loại bỏ.
- Nếu thấy các trang hoặc truy vấn hữu ích nằm trong danh sách đó, hãy sửa lại biểu thức cho chính xác hơn.
- Sau khi đã kiểm tra kỹ, bạn mới chuyển chế độ bộ lọc sang Doesn't match regex để thực hiện loại trừ.
Tại sao tổng số liệu khi dùng bộ lọc Regex không khớp với tổng mặc định?
Sự chênh lệch này là bình thường và xảy ra do cơ chế xử lý dữ liệu của GSC. Khi bạn áp dụng bất kỳ bộ lọc nào (bao gồm Regex), báo cáo chỉ tính toán trên các hàng thỏa mãn điều kiện và vượt qua ngưỡng hiển thị của hệ thống. Những truy vấn ẩn danh hoặc các truy vấn có lượng hiển thị thấp thường bị loại bỏ khỏi các bảng đã lọc, dẫn đến tổng số Click hoặc Impression thấp hơn so với con số tổng quan khi không áp dụng bộ lọc.
Xem thêm:
- Search Console Insights: Hướng dẫn đọc dữ liệu và tối ưu SEO
- Referral Traffic là gì? Cách tối ưu lưu lượng truy cập từ link
- Exit Rate là gì? Cách phân biệt với Bounce Rate chính xác
Kết luận
Regex trong Google Search Console giúp bạn lọc, phân nhóm truy vấn và URL linh hoạt hơn, nhưng hiệu quả phụ thuộc vào việc chọn đúng trường dữ liệu, viết biểu thức RE2 phù hợp và kiểm tra kết quả thực tế. Hãy bắt đầu từ một câu hỏi phân tích cụ thể, thử nghiệm với Matches regex trước khi dùng Doesn’t match regex, đồng thời giữ nhất quán phạm vi ngày và các bộ lọc khi so sánh để đưa ra kết luận SEO chính xác hơn.