AI Crawler là gì? Cách hoạt động và điểm khác biệt so với khác Googlebot
AI crawler là gì?
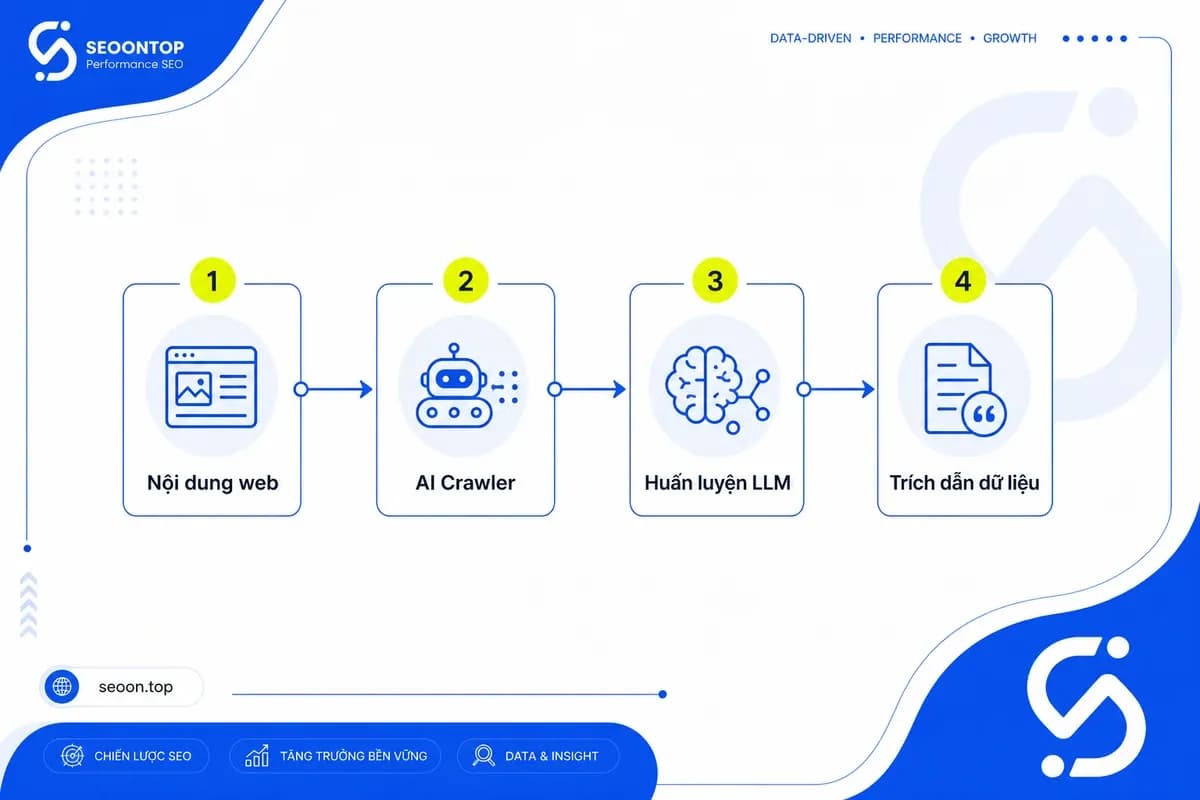
AI crawler là bot tự động truy cập website để thu thập dữ liệu công khai, sau đó dùng dữ liệu đó cho AI search, dữ liệu huấn luyện mô hình ngôn ngữ lớn hoặc các tác vụ của AI agents. Nói ngắn gọn, đây là trình thu thập dữ liệu AI chứ không chỉ là bot phục vụ index tìm kiếm truyền thống.
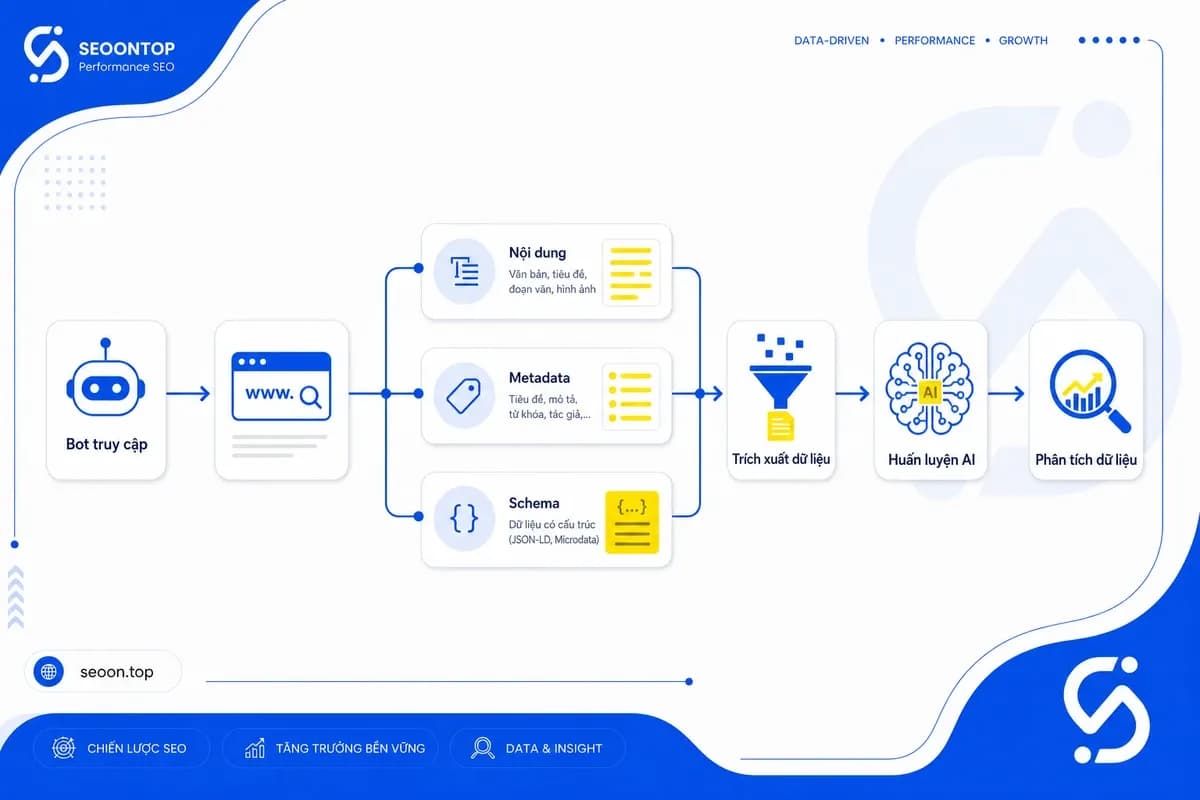
Trong thực tế, AI crawler thường đi qua các URL công khai, đọc nội dung văn bản, tiêu đề, liên kết, metadata và một phần dữ liệu có cấu trúc. Mục tiêu của nó có thể là:
- Phục vụ AI search.
- Lấy training data (dữ liệu huấn luyện).
- Hỗ trợ hệ thống AI trả lời có trích dẫn.
- Làm mới dữ liệu cho các mô hình có truy xuất web.
Điểm khiến chủ đề này được quan tâm nhiều hơn trong 1-2 năm gần đây là sự bùng nổ của ChatGPT, Perplexity, Gemini và các công cụ trả lời bằng AI. Khi AI systems cần đọc web để trả lời tốt hơn, số lượng bot AI thu thập dữ liệu cũng tăng theo.
AI crawler khác “bot thông thường” ở điểm nào?
Không phải bot nào cũng có cùng mục đích: Có bot để index trang cho công cụ tìm kiếm, có bot để kiểm tra uptime, có bot để scrape dữ liệu giá, và cũng có AI bots để làm trích xuất dữ liệu theo ngữ cảnh từ nội dung website.
Khác biệt lớn nhất là AI crawler thường quan tâm nhiều hơn tới:
- Nội dung chính.
- Ngữ cảnh của thông tin.
- Structured data (dữ liệu có cấu trúc).
- Khả năng dùng dữ liệu đó cho trả lời, trích dẫn hoặc huấn luyện.
Ví dụ, một bot tìm kiếm truyền thống có thể ưu tiên hiểu cấu trúc indexation. Trong khi đó, một crawler AI có thể ưu tiên lấy phần nội dung dễ đọc, heading, danh sách và schema để phục vụ hệ thống trả lời của nó.
Ví dụ các AI crawler phổ biến hiện nay
- GPTBot: Bot của OpenAI, thường gắn với mục đích thu thập dữ liệu cho mô hình AI.
- ChatGPT-User: Bot phục vụ truy xuất nội dung khi người dùng tương tác với ChatGPT.
- OAI-SearchBot: Bot liên quan đến lớp AI search của OpenAI.
- PerplexityBot: Bot của Perplexity, thường gắn với trải nghiệm tìm kiếm có trích dẫn.
- Google-Extended: Cơ chế của Google cho phép quản lý việc dùng nội dung cho AI models.
- CCBot / Common Crawl: Crawler thu thập dữ liệu web quy mô lớn cho tập dữ liệu công khai.
- ClaudeBot / anthropic-ai: Bot liên quan đến hệ sinh thái AI của Anthropic.
- Applebot-Extended: Bot phục vụ các tính năng AI/search trong hệ sinh thái Apple.
Lưu ý: AI crawler không mặc định là bot xấu. Điều quan trọng là hiểu bot đó đang phục vụ mục đích gì trước khi ra quyết định quản trị.
AI crawler hoạt động như thế nào trên website?
Về nguyên lý, AI crawler hoạt động khá giống các crawler khác: Nó tự nhận diện bằng user-agent (chuỗi nhận diện bot), truy cập các URL công khai, thực hiện data extraction (trích xuất dữ liệu) và dùng dữ liệu đó cho training data, AI search hoặc mô hình truy xuất như RAG.
Trong quản trị website, luồng hoạt động cơ bản thường diễn ra như sau:
- Bot xuất hiện với một user-agent cụ thể.
- Bot truy cập URL công khai từ link, sitemap hoặc nguồn web mở.
- Bot đọc phần nội dung mà nó có thể tiếp cận.
- Dữ liệu được đưa vào hệ thống search, training hoặc trả lời AI.
- Khả năng truy cập thực tế còn phụ thuộc vào robots.txt, login wall và cách website render nội dung.
Tóm lại, cơ chế hoạt động của AI crawler tương tự các trình thu thập dữ liệu truyền thống. Chúng vẫn phụ thuộc vào cấu trúc URL, khả năng tiếp cận và các quy tắc kỹ thuật của website.
AI crawler thường thu thập những gì?
Những gì bot này đọc được thường là phần nội dung công khai và có cấu trúc tương đối rõ:
- Nội dung thân bài: Đoạn văn, heading, bảng, bullet list.
- Title và heading: Giúp hiểu chủ đề của trang.
- Internal links: Để lần theo các trang liên quan.
- Metadata: Title tag, meta description, rel tags.
- Structured data / schema / JSON-LD: Hỗ trợ hiểu thực thể, tác giả, sản phẩm, FAQ.
- Hình ảnh qua alt text: Chủ yếu ở mức mô tả ngữ nghĩa.
- PDF hoặc tài liệu public: Nếu file mở công khai và không chặn truy cập.
AI crawler dùng dữ liệu đó để làm gì?
Có 3 nhóm mục đích phổ biến nhất:
- Huấn luyện mô hình: Bổ sung dữ liệu cho các mô hình ngôn ngữ lớn.
- Làm mới dữ liệu cho AI search / Real-time RAG: Giúp hệ thống trả lời dựa trên nội dung mới hơn.
- Hỗ trợ citation (trích dẫn) và tạo câu trả lời: Chọn nguồn để trích dẫn hoặc tham chiếu khi trả lời câu hỏi.
Điểm này rất quan trọng: Cùng là crawl, nhưng crawl để training và crawl để phục vụ search có citation là hai giá trị kinh doanh khác nhau.
AI crawler có thể “đọc hết” website không?
Không. AI crawler thường chỉ đọc tốt những gì công khai, dễ truy cập và có cấu trúc rõ. Một số giới hạn phổ biến gồm:
- Robots.txt có thể ảnh hưởng phạm vi truy cập nếu bot tuân thủ quy tắc robots.
- Nội dung sau login, form đăng ký hoặc paywall thường khó tiếp cận hơn.
- Website phụ thuộc nhiều vào JavaScript render phức tạp có thể không được bot nào cũng đọc đầy đủ.
- Nội dung ẩn trong tab động, app-like interface hoặc hệ thống tương tác sâu thường khó crawl hơn.
Ví dụ dễ hiểu: Một bài blog public trên website B2B thường dễ được bot đọc hơn một tài liệu chỉ mở sau khi điền form. Tương tự, một landing page nhiều chữ và schema thường dễ được hiểu hơn một giao diện web app gần như chỉ render sau tương tác người dùng.
Lưu ý: Nếu nội dung của bạn công khai, có cấu trúc rõ và dễ truy cập, khả năng bot AI đọc được sẽ cao hơn đáng kể.
AI crawler khác gì với Googlebot?
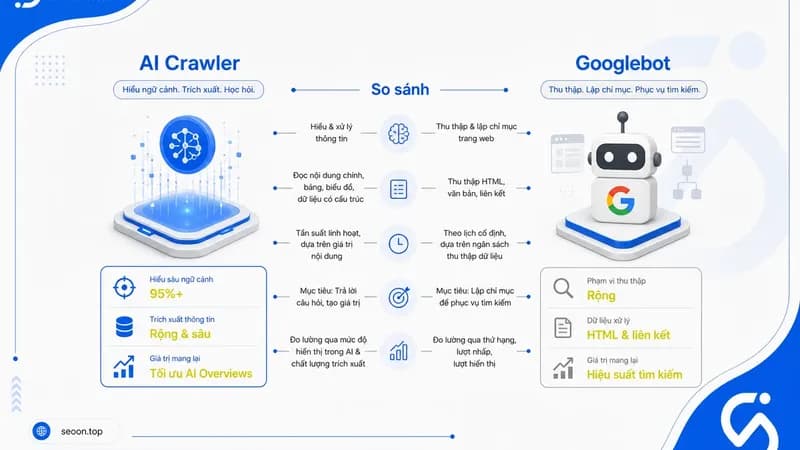
Điểm khác nhau lớn nhất giữa Googlebot và AI crawler nằm ở mục đích thu thập dữ liệu. Googlebot chủ yếu phục vụ hệ sinh thái index và ranking của Google Search, còn AI crawler thường phục vụ huấn luyện (training), trích dẫn (citation), tạo câu trả lời (answer generation) hoặc AI search.
Bảng so sánh AI crawler vs Googlebot
Tiêu chí | Googlebot | AI crawler |
|---|---|---|
Mục đích chính | Thu thập để indexation và phục vụ xếp hạng tìm kiếm. | Thu thập cho training, AI search, citation hoặc trả lời. |
Dữ liệu quan tâm | Nội dung, liên kết, tín hiệu SEO, canonical, cấu trúc trang. | Nội dung chính, ngữ cảnh, metadata, schema, dữ liệu dùng cho AI. |
Vai trò với indexation | Trực tiếp liên quan đến việc lập chỉ mục trên Google. | Thường không trực tiếp phục vụ index Google. |
Ảnh hưởng SEO trực tiếp | Có liên quan trực tiếp đến khả năng xuất hiện trên Google Search. | Không trực tiếp quyết định thứ hạng Google. |
Mức tuân thủ robots.txt | Thường rõ ràng và ổn định hơn. | Khác nhau tùy bot và mức compliance (tuân thủ). |
Tần suất crawl | Có logic dựa trên cập nhật nội dung và tài nguyên site. | Có thể theo đợt, theo batch hoặc theo nhu cầu AI system. |
Khả năng tạo referral traffic / citation | Mang traffic từ tìm kiếm truyền thống. | Có thể mang citation hoặc referral traffic từ AI search, nhưng không phải bot nào cũng có. |
Nói cách khác, nếu đang cần phân biệt Googlebot và AI crawler, hãy nhìn vào câu hỏi: Bot đó crawl để đưa trang của bạn vào kết quả tìm kiếm, hay crawl để cấp dữ liệu cho hệ thống AI?
Điểm dễ gây hiểu lầm nhất với website owner
Có 4 hiểu nhầm rất phổ biến:
- Chặn AI crawler không có nghĩa là chặn Googlebot.
- Không phải bot AI nào cũng mang về traffic hoặc lead.
- Có bot phục vụ AI search, có bot phục vụ training.
- Cùng là AI bot nhưng giá trị kinh doanh rất khác nhau.
Một website B2B có thể muốn mở quyền cho bot có khả năng hỗ trợ citation trong AI search, nhưng lại thận trọng hơn với bot chỉ thu thập training data mà không tạo giá trị thấy được trong ngắn hạn.
Lưu ý: Khi cần phân biệt Googlebot và AI crawler, đừng hỏi bot nào “tốt hơn”. Hãy hỏi bot đó tạo ra giá trị nào và tác động gì cho website của bạn.
AI crawler có ảnh hưởng đến SEO và website không?
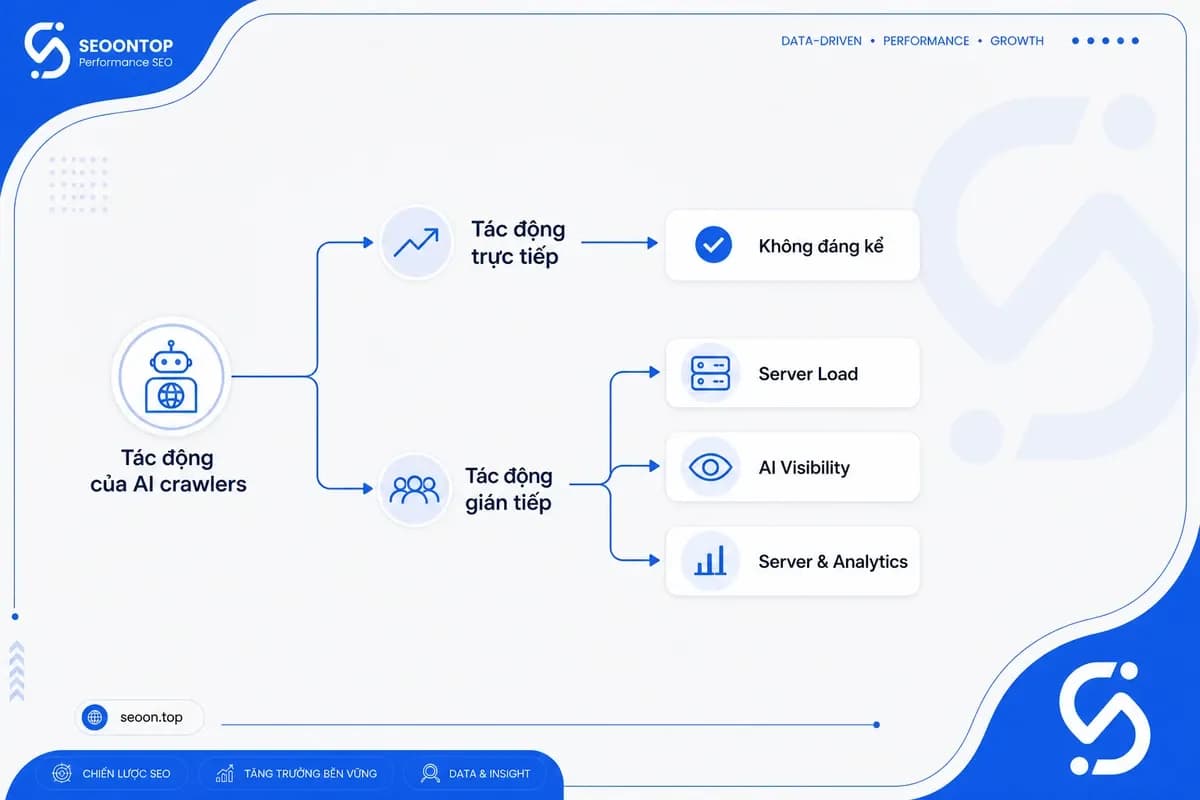
Nếu hỏi về tác động của AI crawler đến thứ hạng SEO, câu trả lời ngắn là: không trực tiếp. Nhưng chúng có thể tạo ra ảnh hưởng gián tiếp đến hiệu năng website, dữ liệu đo lường và khả năng hiện diện trong AI search.
Đây là điểm cần gỡ hiểu nhầm rõ nhất. Thay vì chỉ tập trung vào việc ngăn chặn hay cho phép crawler, doanh nghiệp cần ưu tiên tối ưu hóa nội dung để tăng khả năng được AI trích dẫn nguồn. Tuy nhiên, nếu bot AI gây áp lực lên hạ tầng hoặc nếu bạn muốn xuất hiện nhiều hơn trong hệ sinh thái AI search, tác động gián tiếp lại đáng để theo dõi.
Ảnh hưởng tiêu cực cần lưu ý
- Crawl burst có thể làm tăng tải lên server và gây tăng đột biến tài nguyên.
- Tăng băng thông, request volume và chi phí hosting ở website lớn.
- Có thể làm nhiễu phân tích nếu bot traffic không được lọc tốt.
- Một số bot giả mạo user-agent khiến việc nhận diện khó chính xác.
- Nếu crawl quá dày, tốc độ phản hồi website có thể bị ảnh hưởng, từ đó gián tiếp tác động đến Core Web Vitals.
Điểm này đặc biệt quan trọng với ecommerce, publisher hoặc website có nhiều trang động.
Ảnh hưởng tích cực trong kỷ nguyên AI search
AI crawler không trực tiếp xếp hạng Google, nhưng có thể tạo giá trị gián tiếp trong kỷ nguyên AI search. Những lợi ích tiềm năng gồm:
- Giúp nội dung được AI systems phát hiện.
- Tăng cơ hội được dùng làm nguồn citation.
- Một số nền tảng có thể tạo referral traffic từ câu trả lời AI.
- Hữu ích hơn với website có:
- Dữ liệu gốc.
- Nội dung chuyên môn.
- Cấu trúc rõ.
- Entity nhất quán.
- Schema đầy đủ.
Theo xu hướng thị trường gần đây, traffic giới thiệu từ AI search vẫn còn nhỏ so với Google Search truyền thống. Vì vậy, doanh nghiệp không nên kỳ vọng mở bot AI là traffic tăng ngay. Nhưng về dài hạn, đây là lớp hiện diện mới cần theo dõi.
Phân biệt nhanh: Tác động trực tiếp và gián tiếp
- Trực tiếp đến ranking Google: Gần như không.
- Gián tiếp đến vận hành website: Có thể có.
- Gián tiếp đến AI visibility: Ngày càng quan trọng.
Lưu ý: Đừng nhìn AI crawler chỉ như rủi ro. Cũng đừng nhìn nó như kênh traffic thần kỳ. Đây là một biến số quản trị mới, cần đánh giá cả rủi ro vận hành lẫn cơ hội hiện diện trong AI search.
Có nên chặn AI crawler không? Cách nghĩ đúng cho từng loại website
Câu hỏi có nên cho phép GPTBot truy cập website không không thể trả lời theo kiểu có hoặc không tuyệt đối. Cách đúng là đánh giá theo mục tiêu business, loại nội dung và năng lực hạ tầng của website.
Framework 2 nhóm bot dễ nhớ
Cách đơn giản nhất là tách bot AI thành 2 nhóm trước khi quyết định.
Nhóm bot | Đặc điểm quản trị |
|---|---|
AI search bots | Có thể hỗ trợ AI visibility, citation hoặc traffic giới thiệu. Nếu mục tiêu là hiện diện trong AI search, thường nên cân nhắc mở có chọn lọc. |
Training bots | Chủ yếu thu thập dữ liệu huấn luyện. Nếu nội dung là tài sản cốt lõi hoặc hạ tầng nhạy cảm, nên giám sát kỹ hoặc chặn có chọn lọc. |
Tư duy này giúp chủ website quản lý việc cho bot truy cập theo mục tiêu kinh doanh, thay vì quyết định theo cảm tính.
Nên allow, giám sát hay chặn?
Loại website | Khuyến nghị | Lý do |
|---|---|---|
Website thuần nội dung/blog | Allow có chọn lọc. | Muốn tăng cơ hội được phát hiện và trích dẫn trong AI search. |
Website về dịch vụ B2B | Allow + monitor. | Nội dung chuyên môn có thể hỗ trợ AI visibility, nhưng vẫn cần theo dõi bot nào thực sự tạo giá trị. |
Website bán hàng (Ecommerce) | Thận trọng, monitor trước. | Nhiều trang động, nguy cơ tăng tải server và crawl không mang giá trị tương xứng. |
Nhà xuất bản/nội dung cao cấp | Monitor chặt hoặc block chọn lọc. | Nội dung là tài sản doanh thu, cần ưu tiên bảo vệ và kiểm soát quyền sử dụng. |
Một lưu ý thực tế: Cách chặn AI crawler trong robots.txt là phương án phổ biến, nhưng không nên xem đó là giải pháp duy nhất hay tuyệt đối. Một số bot tuân thủ tốt, một số bot khác có mức tuân thủ khác nhau. Vì vậy, quyết định quản trị luôn nên đi kèm theo dõi log và hành vi thực tế.
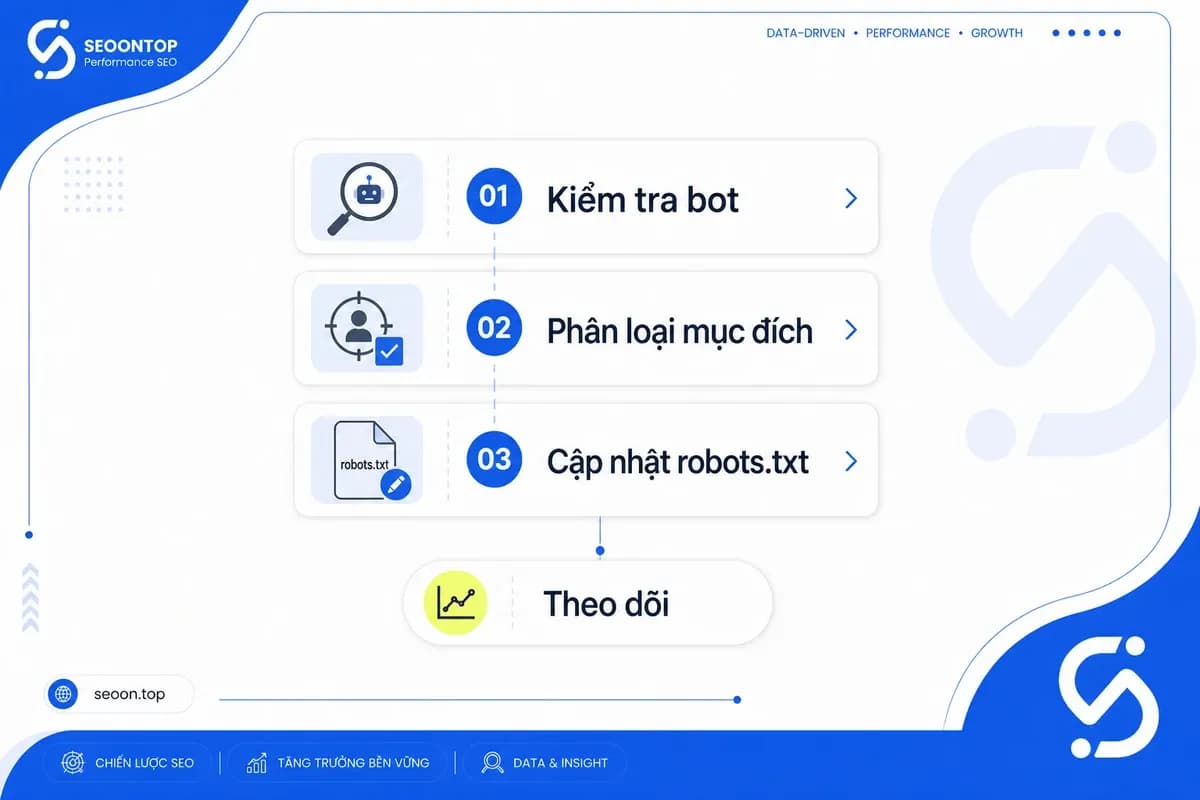
3 bước quản lý cơ bản cho người không chuyên kỹ thuật
- Kiểm tra log truy cập hoặc bot analytics để biết bot nào đang vào website.
- Phân loại bot theo mục đích: Search / training / agent.
- Cập nhật robots.txt và theo dõi lại tác động sau khi thay đổi.
Nếu doanh nghiệp đang tìm hiểu cấu hình robots.txt tối ưu cho AI crawlers, hãy giữ tư duy này trước: Robots.txt là công cụ quản lý quyền ưu tiên, không giải pháp tối ưu có thể giải quyết mọi rủi ro.
Một lưu ý mới đáng quan tâm về thị trường
Gần đây, thị trường đã bắt đầu chuyển từ tư duy “allow hoặc block toàn bộ” sang phân loại bot theo mục đích. Chẳng hạn, Cloudflare đã tách bot AI thành 3 nhóm: Search, Agent và Training, cho thấy xu hướng quản trị trong tương lai sẽ ngày càng tinh vi hơn.
Điều này có ý nghĩa lớn với doanh nghiệp: Cùng là bot AI, nhưng bot search có thể đáng mở hơn bot training, còn bot agent lại cần đánh giá riêng vì có thể tương tác sâu hơn với website.
Không có một đáp án chung cho mọi website. Cách bền vững nhất là phân loại bot trước, rồi mới quyết định allow, monitor hay block.
Góc nhìn thực tiễn: Vì sao AI crawler ngày càng quan trọng trong AEO
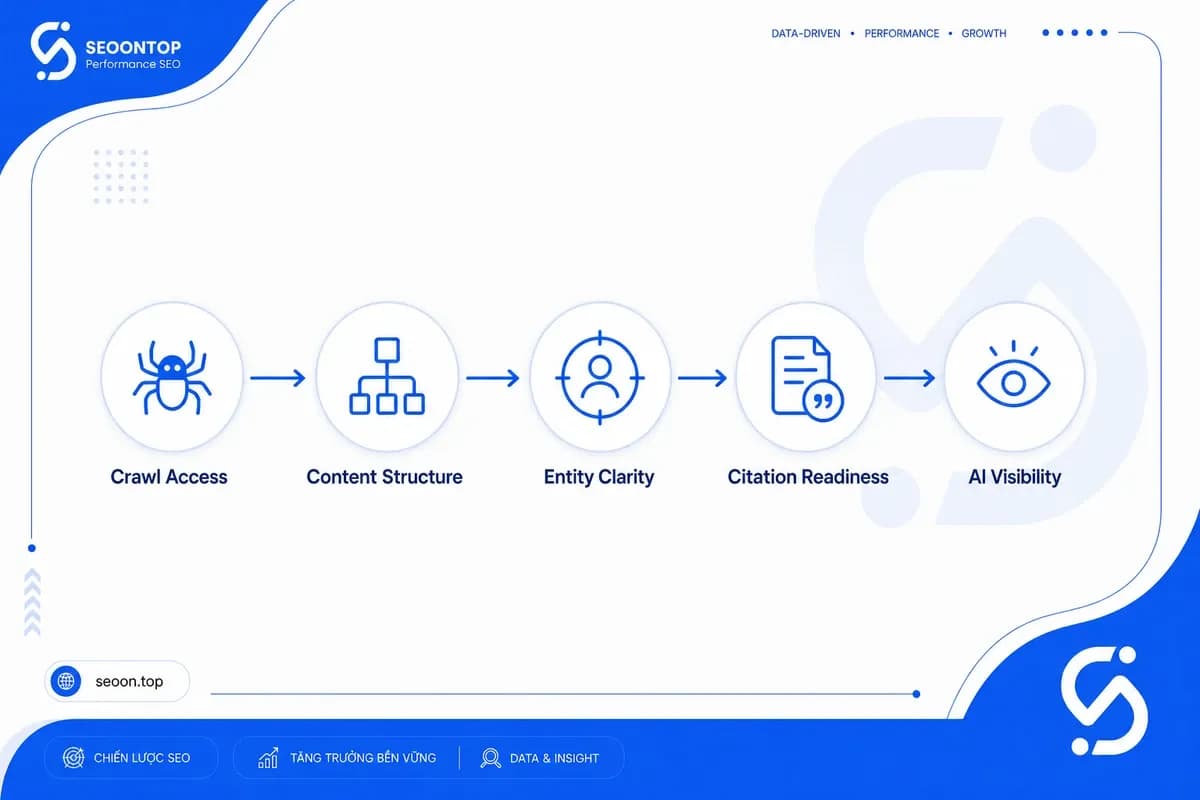
AEO (AI Engine Optimization - tối ưu để nội dung có cơ hội xuất hiện trong các hệ thống trả lời bằng AI) đang khiến chủ đề AI crawler trở nên quan trọng hơn trước. Lý do khá đơn giản: Nếu AI systems không phát hiện được nội dung, cơ hội được nhắc tới trong câu trả lời của chúng sẽ thấp hơn.
Tuy nhiên, cần phân biệt rõ một điểm: Được crawl không đồng nghĩa được citation. AI crawler chỉ là lớp phát hiện và thu thập. Việc nội dung có được dùng làm nguồn tham chiếu hay không còn phụ thuộc vào:
- Độ rõ của entity (thực thể).
- Mức độ đáng tin của thông tin.
- Cấu trúc nội dung.
- Khả năng kiểm chứng.
- Tính cập nhật của dữ liệu.
Điều website doanh nghiệp nên ưu tiên sau khi hiểu AI crawler:
- Hãy nghĩ đến việc nội dung của bạn có đủ khả năng được dẫn nguồn hay không, thay vì chỉ nghĩ đến việc bot có vào đọc được hay không.
- Tăng độ rõ của entity trên website và trong nội dung tác giả/thương hiệu.
- Dùng cấu trúc nội dung như heading, FAQ, bảng, schema.
- Xây nội dung có dữ liệu gốc, có nguồn và dễ kiểm chứng.
Nói cách khác, tối ưu cho AI search không bắt đầu từ việc mở bot, mà bắt đầu từ việc làm cho nội dung rõ ràng, đáng tin và dễ dùng đối với hệ thống AI.
AI crawler là điều kiện phát hiện, còn AI visibility bền vững lại phụ thuộc nhiều hơn vào chất lượng nội dung và tín hiệu tin cậy.
Câu hỏi thường gặp
AI crawler là gì?
AI crawler là các chương trình bot tự động truy cập, đọc và thu thập dữ liệu từ các trang web. Khác với Googlebot tập trung vào việc lập chỉ mục để xếp hạng tìm kiếm, AI crawler thu thập thông tin để phục vụ mục đích huấn luyện mô hình ngôn ngữ lớn (LLM), hỗ trợ AI tìm kiếm (AI search) hoặc cung cấp dữ liệu cho các tác vụ AI thông minh.
AI crawler khác Googlebot ở điểm nào?
Điểm khác biệt lớn nhất là mục đích: Googlebot thu thập dữ liệu để giúp Google hiểu và xếp hạng website trong kết quả tìm kiếm, trong khi AI crawler thu thập để xây dựng cơ sở dữ liệu huấn luyện hoặc cung cấp thông tin cho các câu trả lời của AI. Việc chặn AI crawler không ảnh hưởng trực tiếp đến thứ hạng của bạn trên Google.
Làm thế nào để biết website của tôi có đang bị AI crawler truy cập không?
Bạn có thể kiểm tra tệp nhật ký (server logs) hoặc sử dụng các công cụ phân tích bot (bot analytics). Hãy tìm kiếm các "user-agent" đặc trưng như GPTBot, ChatGPT-User, CCBot hoặc PerplexityBot. Một số dịch vụ quản trị bot như Cloudflare cũng cung cấp báo cáo chi tiết về lưu lượng truy cập từ các loại trình thu thập dữ liệu này.
Việc chặn AI crawler có làm giảm thứ hạng SEO không?
Không. Google đã xác nhận rằng việc chặn các trình thu thập dữ liệu AI (như GPTBot) không ảnh hưởng trực tiếp đến thứ hạng của bạn trên công cụ tìm kiếm Google. Tuy nhiên, nếu bạn chặn tất cả, website của bạn có thể không xuất hiện trong các câu trả lời hoặc tính năng trích dẫn nguồn của các công cụ AI search.
Tôi có nên chặn toàn bộ AI crawler không?
Không nên chặn tất cả một cách mặc định. Bạn nên phân loại bot: Hãy cho phép các bot phục vụ AI search (như ChatGPT-User, PerplexityBot) nếu bạn muốn tăng độ nhận diện, nhưng có thể giám sát hoặc chặn các bot chuyên thu thập dữ liệu huấn luyện nếu bạn muốn bảo vệ tài nguyên máy chủ hoặc giữ nội dung độc quyền.
Làm thế nào để quản lý AI crawler trên website?
Bạn có thể quản lý qua tệp robots.txt bằng cách thiết lập Disallow cho các user-agent cụ thể. Với các website lớn, bạn nên sử dụng giải pháp quản trị bot (Bot Management) để phân loại lưu lượng truy cập thành các nhóm: Tìm kiếm (Search), Tác vụ (Agent) và Huấn luyện (Training) để có chính sách kiểm soát phù hợp.
AI crawler có ảnh hưởng đến tốc độ website không?
Có thể. Nhiều AI crawler hoạt động theo cơ chế "burst" (truy cập ồ ạt trong thời gian ngắn), gây áp lực lớn lên tài nguyên máy chủ và băng thông. Nếu website của bạn bị crawler truy cập quá mức, tốc độ phản hồi có thể giảm, từ đó ảnh hưởng đến các chỉ số Core Web Vitals của người dùng thật.
Xem thêm:
- Cách AI Search Engines hoạt động: Cơ chế cốt lõi cần biết
- Answer Engine Optimization là gì? Tối ưu hóa cho AI Search
- Conversational search là gì? Tối ưu SEO cho thời đại AI Search
Kết luận
AI crawler là lớp bot mới mà website owner cần hiểu đúng trong bối cảnh AI search tăng trưởng nhanh. Điểm cốt lõi cần nhớ là: Bot này dùng để thu thập dữ liệu cho AI search, training hoặc tác vụ AI khác; nó không trực tiếp quyết định ranking Google, nhưng có thể tạo tác động gián tiếp đến hạ tầng, analytics và AEO / AI visibility. Vì vậy, doanh nghiệp không nên phản ứng cực đoan theo hướng mở hết hoặc chặn hết.
Cách tiếp cận thực dụng nhất là: Xác định bot nào đang vào website, phân loại theo mục đích và ra quyết định dựa trên mục tiêu business. Nếu cần một bước tiếp theo, hãy bắt đầu bằng checklist rà soát bot AI cơ bản, sau đó đối chiếu với chiến lược nội dung và khả năng hiện diện của website trong AI search.